【金融之一】研報洪流中的「原典錨定」:為什麼投研備忘錄不能自動越界為交易指令
投研的核心價值在於投資論點與原始披露之間可追溯的證據鏈;即便大模型能捕捉快訊情緒,開放式財務問答仍受困於檢索漏損與幻覺,生成正反證據備忘與投委會決策、交易執行必須在架構上嚴格隔離。
快訊情緒評分與深度公告核驗之間的鴻溝
設想一家資管機構的投研團隊在財報季面臨密集的定期報告與市場快訊。為了緩解閲讀壓力,團隊嘗試將公告與新聞流接入大模型生成投資摘要,甚至討論把模型輸出的看多或看空評分直接連入交易指令接口。但在內部複核中,研究員很快遇到瓶頸:模型固然能從新聞標題中提取短期情緒方向,可一旦投委會追問某項資本開支、表外負債或盈利指引在長篇年報中的具體出處,自動生成的段落往往缺失可核對的原始證據鏈,或把常規財務科目誤判為負面信號。若未經核驗的摘要直接觸發下單,上游文本解析偏差就會轉化為真實頭寸風險。
這一困境揭示了金融投研智能化的核心原則:投研的價值在於論點與原始披露之間可追溯的證據鏈;生成正反證據備忘與投委會決策、交易執行必須在架構上嚴格隔離。
情緒預測力、金融語境錯配與開放式財務問答的侷限
為何不能因為大模型具備市場情緒捕捉能力,就放任其越過人工複核直接驅動交易?金融文本分析與大模型評測研究界定了其中的能力邊界與機制差異。
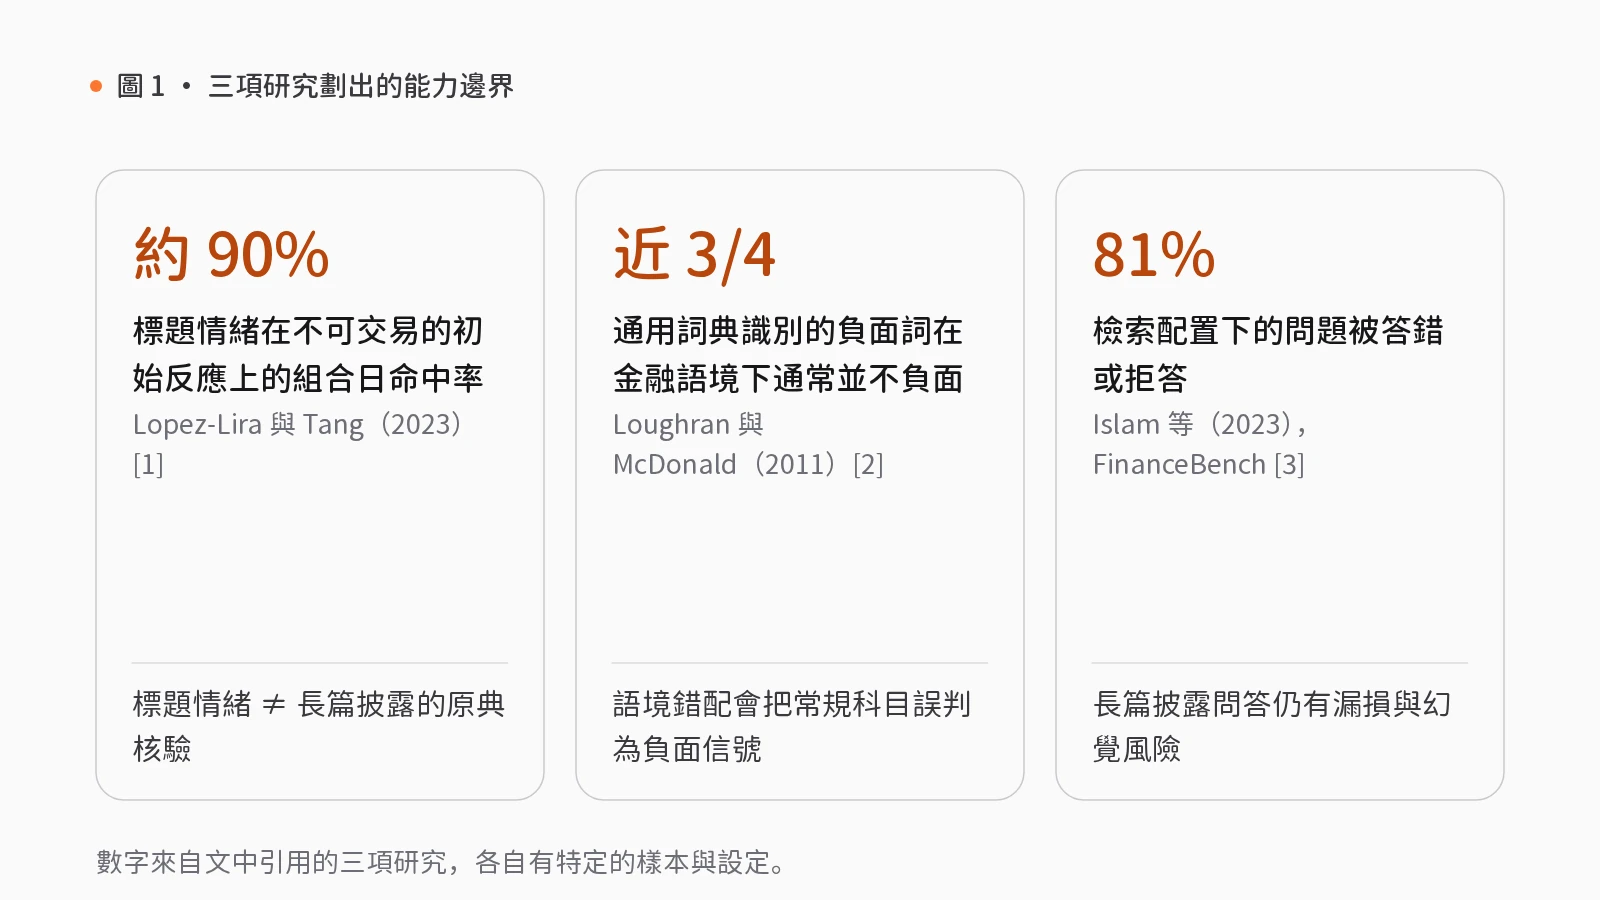
首先,大模型在處理新聞標題時的確展現出情緒歸納與收益預測能力。Lopez-Lira 與 Tang(2023)記錄了大模型在未經直接金融訓練的情況下,僅憑新聞標題預測股市反應的能力[1]。在使用知識截止日期之後的新聞標題測試時,受測前沿模型捕捉到了市場初始反應,在不可交易的初始反應上取得了約 90% 的組合日命中率[1];其情緒評分還能顯著預測隨後的價格漂移,在小盤股與負面新聞中尤為明顯[1]。研究顯示,預測能力總體隨模型規模擴大而增強,表明金融推理是複雜大模型的湧現能力;隨着大模型採納率上升,策略收益呈下降趨勢,與市場價格效率改善一致[1]。作者通過構建包含大模型技術、資訊處理能力約束、反應不足與套利限制的理論模型解釋了上述發現[1]。
但架構設計必須區分新聞標題情緒打分與深度披露原典核驗。標題情緒捕捉的是市場對快訊的短期反應不足與漂移,而投研備忘錄處理的是複雜的法定披露文件。Loughran 與 McDonald(2011)針對 10-K 年報的研究指出,早期研究常以負面詞計數衡量語調,但為其他學科開發的詞表在金融文本中會誤判常見詞彙[2]。在對 1994 年至 2008 年的大樣本年報的分析中,一套廣泛使用的通用學科詞典識別出的負面詞裏,近四分之三在金融語境下通常並不負面[2](如負債在資產負債表中只是常規科目)。作者為此開發了替代性金融負面詞表及其餘五類專項詞表以反映金融語調,並將詞表與年報披露期收益、交易量、收益波動率、欺詐、重大內部控制缺陷及未預期盈餘建立了關聯[2]。
當通用大模型配合檢索系統面對上市公司財務披露文檔時,能否勝任精確問答與核驗?Islam 等(2023)發佈了評估大模型開卷金融問答表現的基準測試集 FinanceBench,包含關於上市公司的 10,231 個問題及對應答案與證據字符串[3]。這些問題具備生態效度、覆蓋多樣場景且明確直接,旨在作為最低表現標準[3]。研究團隊在抽樣的 150 個案例上測試了 16 種結合向量庫或長上下文提示詞的前沿模型配置,並人工審閲了 2,400 條回答,發現現有大模型存在明顯侷限:配合檢索系統的前沿模型配置對 81% 的問題回答錯誤或拒絕回答[3]。雖用更長上下文窗口輸入相關證據能改善表現,但因延遲增加且無法支援更大體量的金融文檔,在企業環境中並不現實;所有受測模型均暴露出幻覺等弱點,限制了企業適用性[3]。
由此可見,大模型雖能輔助提煉文本信號,但在長篇披露的精確問答中仍存漏損與幻覺風險;投研系統的職責不是替基金經理下單,而是把披露原文、正反論據與人工複核組裝成可追查的證據賬本。
工程映射:從證據備忘錄到跨週跟進的受控流水線
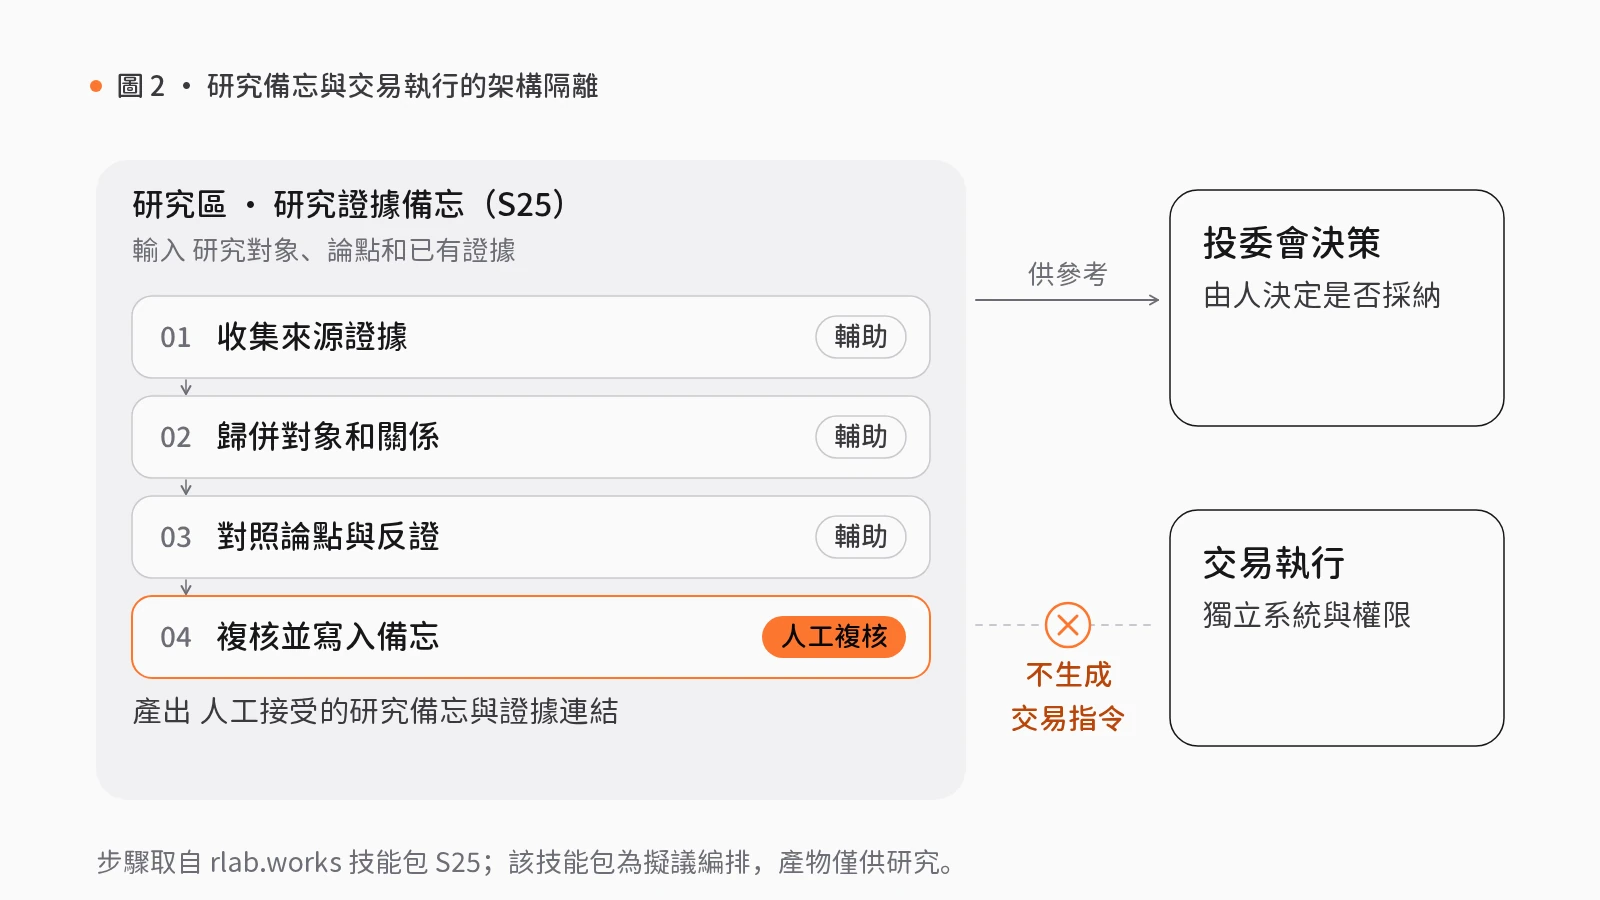
在 rlab.works 體系中,原典錨定與研究交易隔離被具象化為契約流程。在智能感知模組下,「正反證據備忘(S25)」技能包以研究對象、論點和已有證據為初始輸入,分步推進:
- 收集證據(輔助):調用「資訊披露採集與文本提取」,獲取美股、A 股和港股公告元數據,從 JSON、HTML 和含文本層的 PDF 中清理出公告正文,產出帶日期與出處的材料包。
- 梳理對象與關係(輔助):在統一標的代碼與時間口徑下整理實體關係與證據索引。
- 對照正反證據(輔助):藉助「投資論點證據與結論跟蹤」,校驗跨多週的論點證據,為來源評級,區分支援、反對與複雜化因素,推導可人工覆蓋的每週結論,產出支援、反對與不確定性記錄。
- 定稿備忘(人工複核):由流程指定的複核人或提出請求的用戶審閲證據鏈;通過後由「投資備忘錄生成」基於市場與披露上下文及既有研究或回測產物,保存人工接受的研究備忘與證據連結;被拒絕的產出退回修訂,不進入下一步。
「正反證據備忘(S25)」在金融行業標為源數據有行業依據:可把披露、市場序列和論點反證放進同一本研究備忘,方便複核每條判斷的出處;但仍需統一實體與時間口徑,且產物僅供研究,不生成交易指令。若遷往法律場景,則屬可遷移應用,須將金融披露、行情和公司模型整體替換成案卷、法條、當事方與時間線,原評分不可移作法律判斷。
需如實説明邊界:上述技能包均為擬議編排,僅含合成數據演示,尚未接入真實服務;所涉組件的可運行代碼成熟度基於靜態源碼檢查而非生產部署。源數據有行業依據僅表示源數據有顯式行業關聯,不代表客戶部署或業務效果。
投研智能體試點前的管理檢驗清單
研究總監、風控官或技術負責人在資助試點前,可執行以下檢驗:
- 是否強制並列呈現支援證據、反證與原始出處? 要求備忘錄同時保留支援、反對與不確定性記錄,並錨定公告具體出處與日期,拒絕只給單向結論的摘要。
- 在檢索補查與備忘歸檔處是否設有阻斷式人工關口? 確認未經複核人接受的草稿與補查計劃會退回修訂,不得寫入研究庫或流入投委會材料。
- 研究備忘與交易執行接口是否實現了架構隔離? 確認智能體輸出止步於研究備忘錄,嚴禁模型評分或摘要跨越投委會決策直接觸發交易指令。
覺得有用?分享給需要的人。
參考文獻
- [1]
Lopez-Lira, A., & Tang, Y. (2023). Can ChatGPT Forecast Stock Price Movements? Return Predictability and Large Language Models (SSRN Working Paper No. 4412788). doi.org/10.2139/ssrn.4412788
- [2]
Loughran, T., & McDonald, B. (2011). When Is a Liability Not a Liability? Textual Analysis, Dictionaries, and 10-Ks. The Journal of Finance, 66(1), 35–65. doi.org/10.1111/j.1540-6261.2010.01625.x
- [3]
Islam, P., Kannappan, A., Kiela, D., Qian, R., Scherrer, N., & Vidgen, B. (2023). FinanceBench: A New Benchmark for Financial Question Answering (arXiv:2311.11944). arxiv.org ↗