报告越笃定,越要回看证据:研究智能体的“抹平”与证据配比
研究与简报智能体生成的报告往往引用密集,但“有出处”不等于结论力度与范围恰当。新近研究显示,智能体普遍会把存在分歧或条件限制的多源证据“抹平”为过度笃定与宽泛的论断,且必须同时提供完整全文与校准指令才能显著降低;同时,属实但单边的证据池也会带偏立场。工程上须按论断并排复核支持与限定证据、记录原文是否打开、在争议议题中配平证据池。

句句都有真实出处,为何研究报告的结论依然失真
设想投研、法务或媒体的审阅人检查一份研究智能体起草的综述。报告每段末尾都附有真实链接,抽查几处后确有相关语句,审阅人便予放行。但原文只证明“某方法在特定小样本实验中有效、高并发下失效”,报告却写成了“充分证据表明该方法普遍优于传统方案”。
这种失真不同于捏造虚假判例,也不同于工具格式化遗漏截断上限。此处引用的材料完全真实,问题出在结论的力度、范围与证据池构成上。当复核只问“有无引用”时,两类隐患便会漏网:一是智能体综合多份文献时抹去限定条件,把局部证据夸大为普适定论[1];二是进入上下文的文档虽各自属实,却集中于单一立场,使回答整体偏斜[2]。
从单篇概括偏差到多源“抹平”与立场失衡:三项实证机制
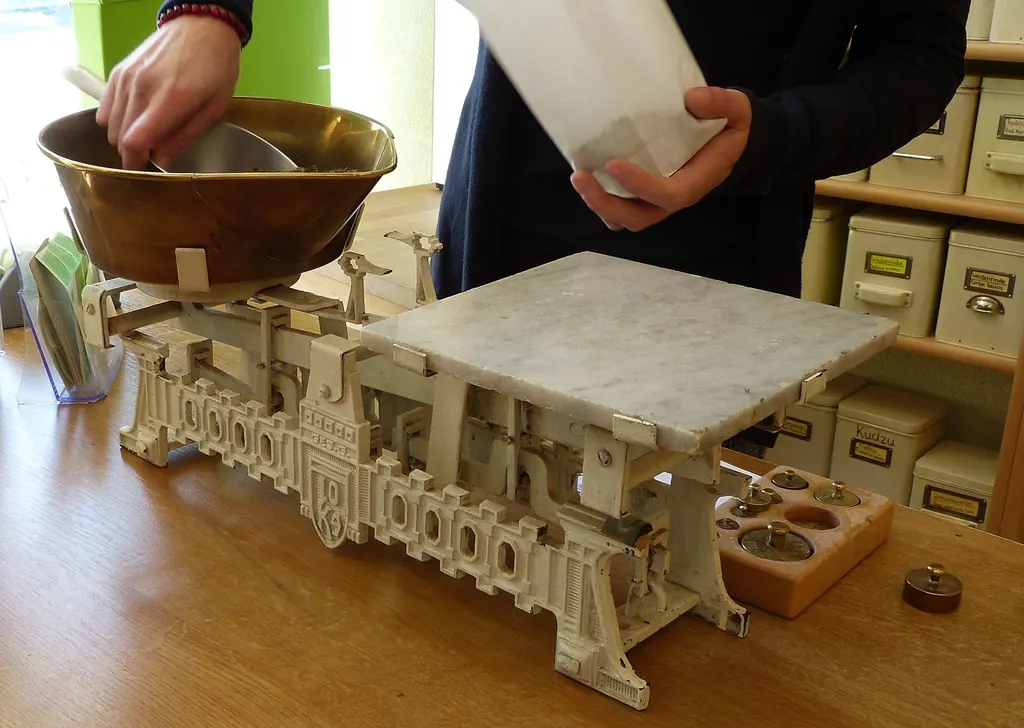
概括单篇文献时,这种放大已有先例。Peters 与 Chin-Yee(2025)对比了 10 个主流大模型生成的 4,900 篇科学摘要与原文:即便明确提示要求准确,多数模型仍给出比原文更宽泛的概括,其中三个模型在 26% 至 73% 的案例中过度概括;直接对比显示,模型摘要出现宽泛概括的可能性接近人类摘要的五倍(比值比 4.85),且较新模型往往更差[3]。
在跨多源文献的研究智能体中,这一倾向演变为“论断抹平”。Roy、Wadhwa 与 Durrett(2026)界定,一条论断若同时满足三项条件即为被抹平:(1)它是从汇总证据得出的结论;(2)部分引用证据确实支持其中至少一部分;(3)结论整体比全部引用证据所能支撑的更强或更宽泛——忠实表述应在证据混杂时保持保留、在支持有限时收窄范围[1]。作者从报告中提取结论性论断,在报告自引文档上分别运行提取支持证据的通道与收集限定、边界或反驳证据的质疑通道,按维度聚类后由模型评判器按 1 至 5 分打分(3 分及以上为实质性抹平,4 分及以上为严重抹平);在 73 条论断的人工核验中,评判器与人类标注员分差在 1 分以内的比例达 93%,一致性与两名人类标注员之间相当[1]。
在 7 个系统与 4 个研究基准的评测中,每个系统在每个数据集上都出现了实质性抹平,占比至少 22%,多数系统超过论断总数的一半;严重抹平跨系统差异悬殊,最低的两个系统为 1% 至 4%,最高者达 22% 至 35%[1]。抹平反复呈现三种模式:无据拼合(把各自有据的片段拼成更强结论)、范围扩张(把单一设定下的结果写成普遍规律)与过早定论(使用“确凿证明”“最佳方案”等字眼);“哪种更有前景及原因”等比较型提问与主题综述型提问尤易诱发抹平[1]。作者还发现,被测智能体很少打开所引网页:一个系统仅打开了所引页面的 19%(主要靠中位长度 585 字符的搜索摘要写作),另一个仅打开 2%[1];作者据此认为,抹平部分取决于智能体选择读取哪些信息[1]。在一个基准 61 个问题上对两个系统的干预表明,单加校准指令或单给完整全文都不足以单独解决问题;唯有同时提供完整文档与校准指令,实质性抹平才分别从 29% 降至 12%、从 61% 降至 25%,严重抹平几乎消失(0.5% 与 2.2%),且报告未变短,论断保留主旨并补上了限制条件[1]。该结论受限于模型评判器评分(经 73 条校验)与研究型基准问题;同一系统内文档数与论断长度同抹平几乎无关,说明仍有其他因素[1]。
工程落地与 rlab.works 能力映射:论断复核、阅读留痕与配额约束
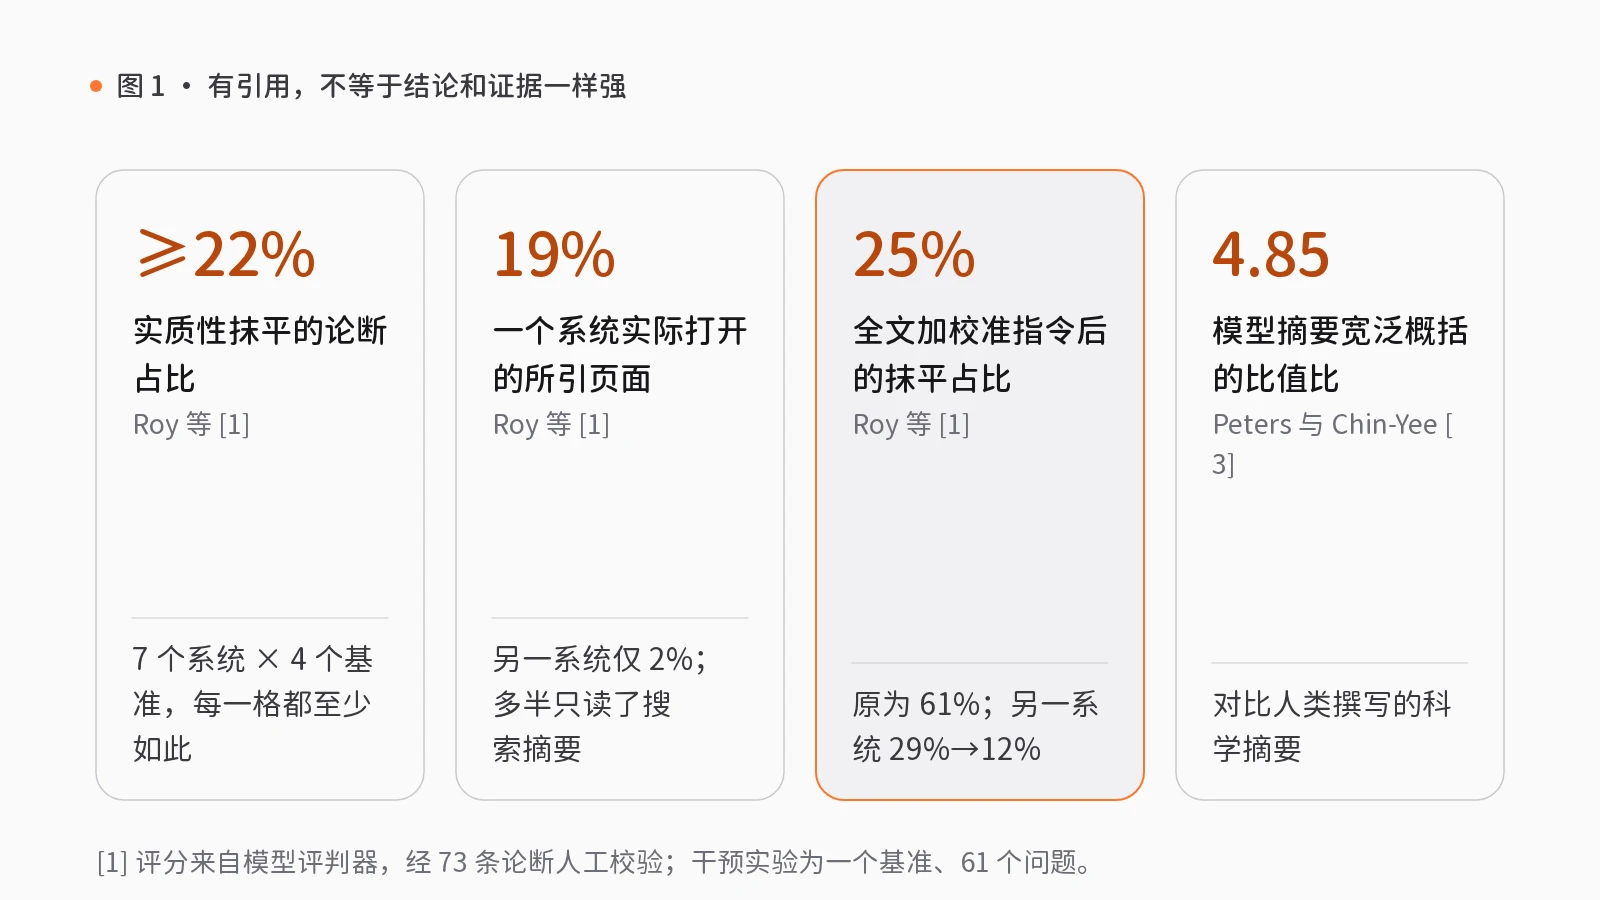
基于此,我们的工程判断是:(1)在论断层面并排展示支持与限定证据,核查结论力度与范围是否匹配,而非只看有无引用;(2)记录每处引用是否真正读取全文,对仅靠摘要的论断打标;(3)对争议问题在写作前固定支持、反对与中立证据配比;(4)同时向写作端提供完整原文与校准指令;(5)重点盯防比较型与综述型问题;(6)在人工关口展示反证与范围边界,允许审阅人下调措辞。
在 rlab.works 的智能感知与智能中枢模块中,可映射三项技能包与三项组件:
- 查资料与报告起草:智能感知的研究报告撰写(S24)执行“拆解问题与范围 → 收集材料 → 撰写引用草稿 → 核对论据(人工关口) → 排版并导出”,可配合有界的跨供应商研究工具循环(有迭代上限的检索工具循环,返回引用与步骤证据)与有依据的文档摘要(生成带引用与源元数据的摘要,并标注兜底结果)。该包在法律行业可迁移:需替换论文来源与新闻主题模型,审查法律效力与判例适用性,不自动化出具法律结论。我们的工程判断是在“核对论据(人工关口)”并排展示支持与限定证据,并标注引用页是否已读全文。
- 跨周期补查与复核:智能中枢的研究续查与归档(S08)执行“调取已有研究 → 制定补查计划 → 批准后执行(人工关口) → 确认新发现(人工关口)”。该包在金融行业可迁移:研究执行仍需对接通用搜索与信息增补队列,因此整包未标为源数据直接支持的金融方案。我们的工程判断是在“确认新发现(人工关口)”核查新证据是否收窄既有结论范围,防止多轮汇总把局部结果抹平。
- 日常资讯汇集与简报:智能感知的每日信息简报(S20)执行“采集并去重 → 提取事实 → 关联相关事件 → 核实并筛选(人工关口) → 生成并发送”,可配合事件、实体与叙事图谱构建(将文章关联为事件与叙事,提取参与方及其立场)。该包在传媒行业有源数据验证:需配置栏目与订阅范围,编辑责任留在复核环节。我们的工程判断是针对争议议题在进入“核实并筛选(人工关口)”前核查立场配比。
需如实说明边界:上述技能包均为基于合成数据演示的拟议未集成方案;三项组件虽经静态源码检查标为可用,但目前均未对论断力度与范围打分、未强制立场配额,也不检查被引用页面是否真正打开——这些是我们从论文提炼的工程要求。本文不构成法律、投资或编辑建议。
研究智能体上线前的三项检验清单
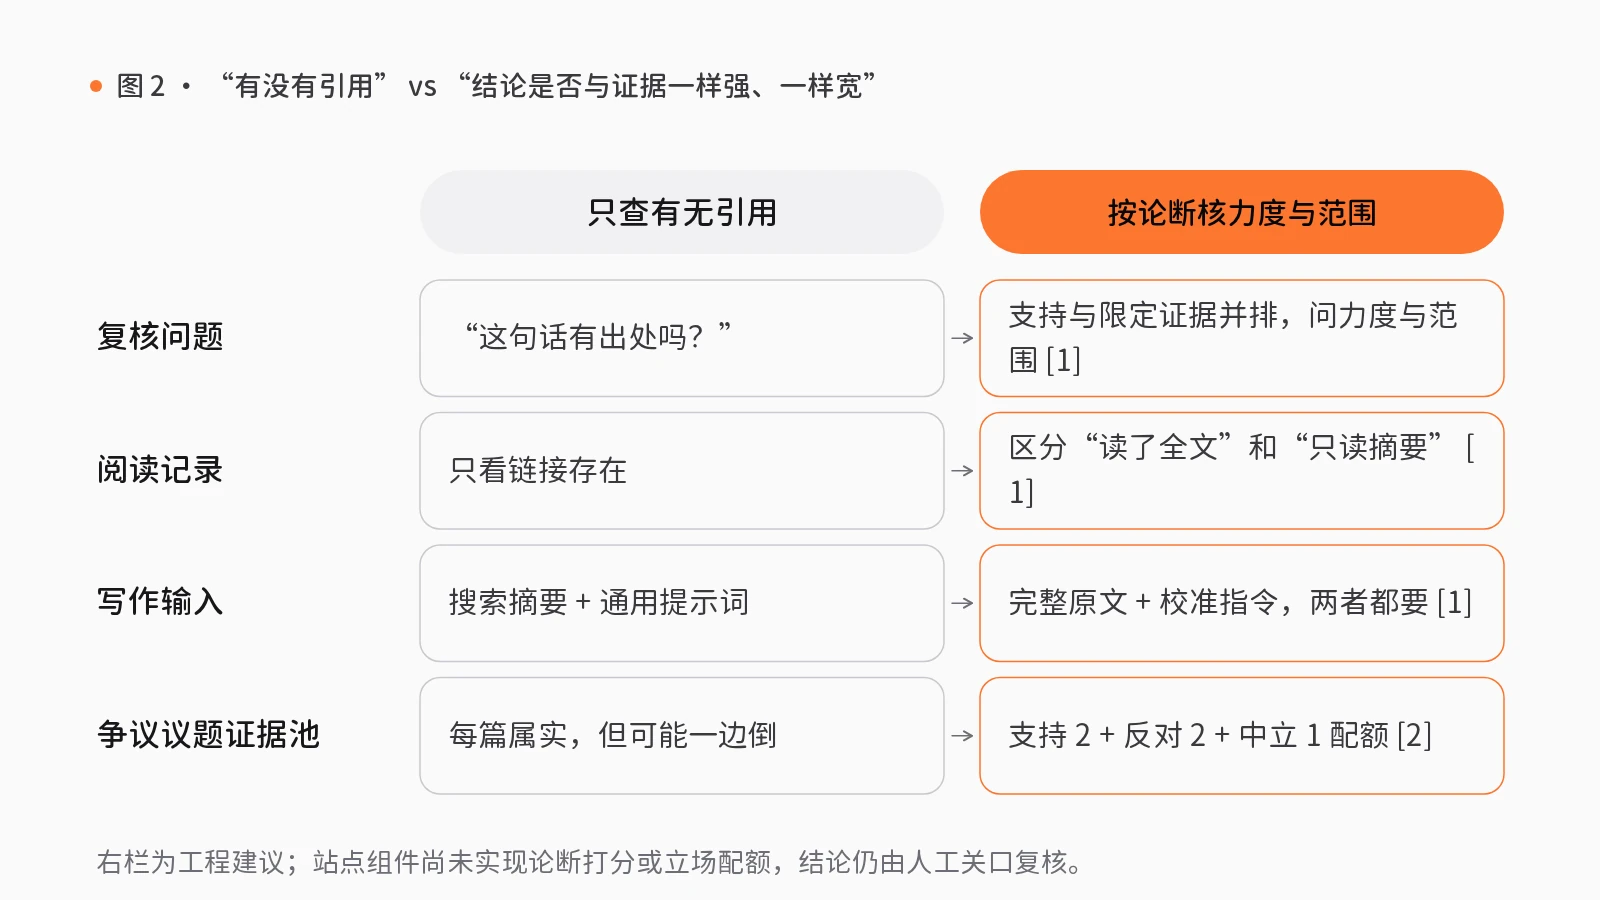
- 核查全文打开记录与双条件输入:确认日志区分“仅读搜索摘要”与“已读全文”,并为写作环节同时配置完整原文与校准指令。
- 核查争议议题的证据池配比:对存在合理分歧的问题,在检索与生成间设置支持、反对与中立文档配额,防止单边材料主导结论。
- 核查人工关口的反证与降级机制:在“核对论据(人工关口)”“确认新发现(人工关口)”与“核实并筛选(人工关口)”同屏展示限定证据,支持审阅人下调措辞强度与范围。
觉得有用?分享给需要的人。
参考文献
- [1]
Roy, T. S., Wadhwa, M., & Durrett, G. (2026). Quantifying claim smoothing by LLM research agents (arXiv:2610.35793). arxiv.org ↗
- [2]
Yang, P., Dong, S., Wu, L., Cheng, X., & Li, B. (2026). Factual yet one-sided: Stance poisoning and evidence balancing in retrieval-augmented generation (arXiv:2610.34294). arxiv.org ↗
- [3]
Peters, U., & Chin-Yee, B. (2025). Generalization bias in large language model summarization of scientific research. *Royal Society Open Science*, 12(4), 241776. doi.org/10.1098/rsos.241776
相关能力
技能包
S24 · 智能感知
研究报告撰写
撰写研究报告时,大量时间用于查找资料、核对引用,仍难以说清每句话的出处。
先拆解研究问题,收集材料并标注出处,撰写带引用的草稿,论据经人工核对后排版导出。
- 拆解问题与范围
- 收集材料
- 撰写引用草稿
- 核对论据人工复核
- 排版并导出
5 步1 处人工复核8 个组件
S08 · 智能中枢
研究续查与归档
研究中途换人或间隔数周再接手,已查内容与结论依据难以找回。
研究范围与证据全部存档;补查前先报步骤与预算,经批准后执行,新发现经确认后归档。
- 调取已有研究
- 制定补查计划
- 批准后执行人工复核
- 确认新发现人工复核
4 步2 处人工复核6 个组件
S20 · 智能感知
每日信息简报
每天需查阅数十个信息源,重复多、有效少,转述时还常遗漏出处。
自动采集并去重,提取事实与相关事件,经人工核实筛选后,生成可订阅的每日简报。
- 采集并去重
- 提取事实
- 关联相关事件
- 核实并筛选人工复核
- 生成并发送
5 步1 处人工复核9 个组件