報告越篤定,越要回看證據:研究智能體的「抹平」與證據配比
研究與簡報智能體生成的報告往往引用密集,但「有出處」不等於結論力度與範圍恰當。新近研究顯示,智能體普遍會把存在分歧或條件限制的多源證據「抹平」為過度篤定與寬泛的論斷,且必須同時提供完整全文與校準指令才能顯著降低;同時,屬實但單邊的證據池也會帶偏立場。工程上須按論斷並排複核支援與限定證據、記錄原文是否打開、在爭議議題中配平證據池。

句句都有真實出處,為何研究報告的結論依然失真
設想投研、法務或媒體的審閲人檢查一份研究智能體起草的綜述。報告每段末尾都附有真實連結,抽查幾處後確有相關語句,審閲人便予放行。但原文只證明「某方法在特定小樣本實驗中有效、高並發下失效」,報告卻寫成了「充分證據表明該方法普遍優於傳統方案」。
這種失真不同於捏造虛假判例,也不同於工具格式化遺漏截斷上限。此處引用的材料完全真實,問題出在結論的力度、範圍與證據池構成上。當複核只問「有無引用」時,兩類隱患便會漏網:一是智能體綜合多份文獻時抹去限定條件,把局部證據誇大為普適定論[1];二是進入上下文的文檔雖各自屬實,卻集中於單一立場,使回答整體偏斜[2]。
從單篇概括偏差到多源「抹平」與立場失衡:三項實證機制
概括單篇文獻時,這種放大已有先例。Peters 與 Chin-Yee(2025)對比了 10 個主流大模型生成的 4,900 篇科學摘要與原文:即便明確提示要求準確,多數模型仍給出比原文更寬泛的概括,其中三個模型在 26% 至 73% 的案例中過度概括;直接對比顯示,模型摘要出現寬泛概括的可能性接近人類摘要的五倍(比值比 4.85),且較新模型往往更差[3]。
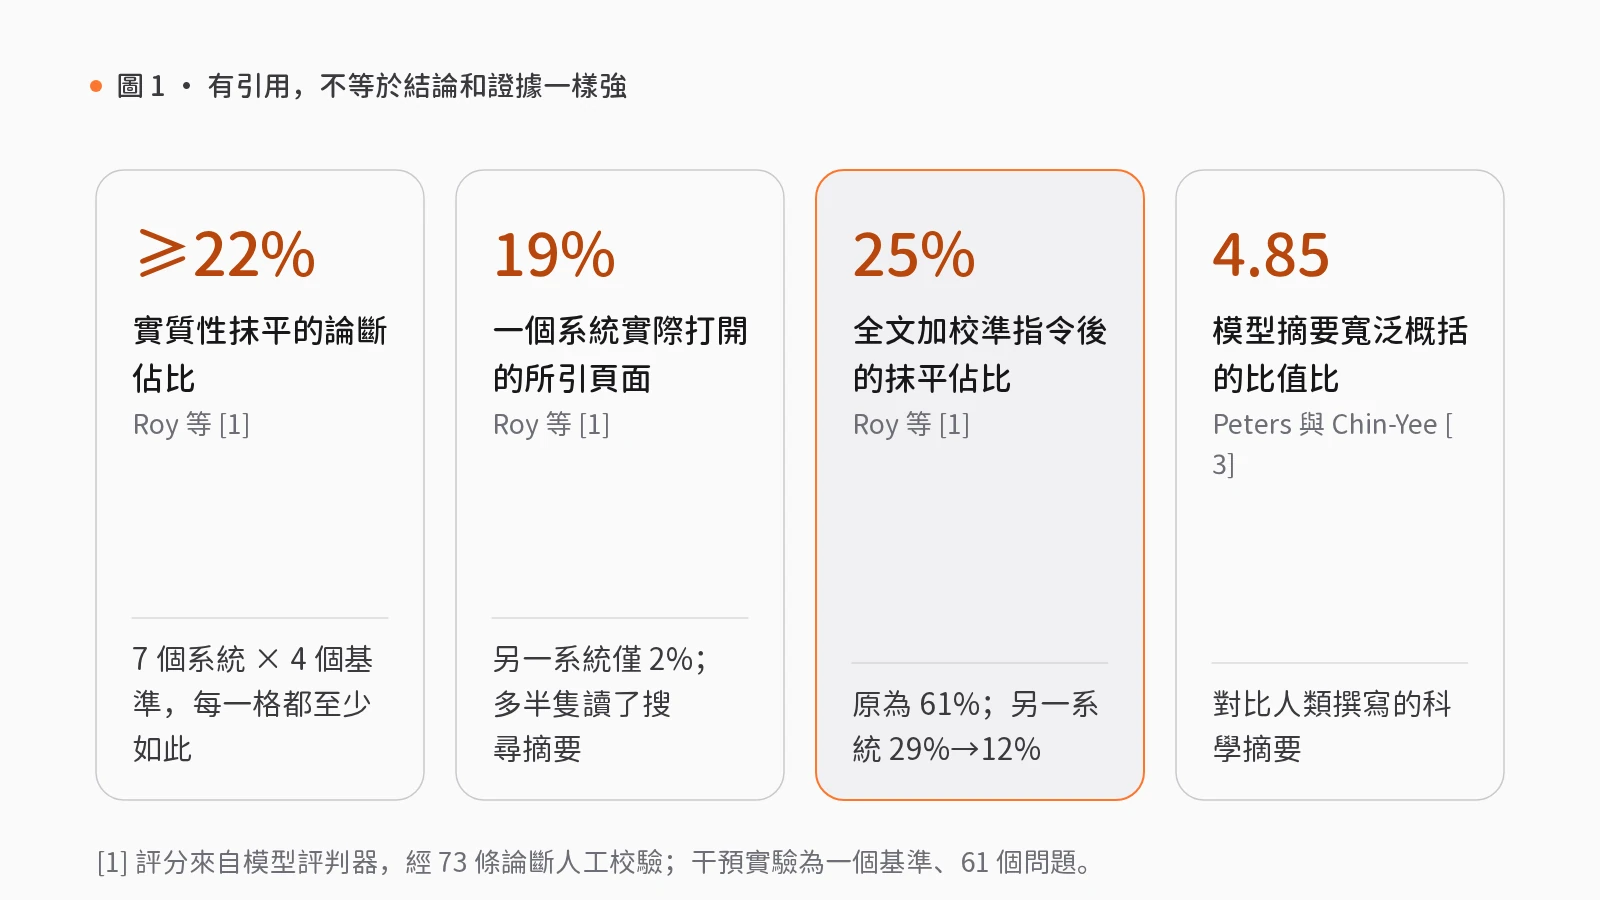
在跨多源文獻的研究智能體中,這一傾向演變為「論斷抹平」。Roy、Wadhwa 與 Durrett(2026)界定,一條論斷若同時滿足三項條件即為被抹平:(1)它是從彙總證據得出的結論;(2)部分引用證據確實支援其中至少一部分;(3)結論整體比全部引用證據所能支撐的更強或更寬泛——忠實表述應在證據混雜時保持保留、在支援有限時收窄範圍[1]。作者從報告中提取結論性論斷,在報告自引文檔上分別運行提取支援證據的通道與收集限定、邊界或反駁證據的質疑通道,按維度聚類後由模型評判器按 1 至 5 分打分(3 分及以上為實質性抹平,4 分及以上為嚴重抹平);在 73 條論斷的人工核驗中,評判器與人類標註員分差在 1 分以內的比例達 93%,一致性與兩名人類標註員之間相當[1]。
在 7 個系統與 4 個研究基準的評測中,每個系統在每個數據集上都出現了實質性抹平,佔比至少 22%,多數系統超過論斷總數的一半;嚴重抹平跨系統差異懸殊,最低的兩個系統為 1% 至 4%,最高者達 22% 至 35%[1]。抹平反覆呈現三種模式:無據拼合(把各自有據的片段拼成更強結論)、範圍擴張(把單一設定下的結果寫成普遍規律)與過早定論(使用「確鑿證明」「最佳方案」等字眼);「哪種更有前景及原因」等比較型提問與主題綜述型提問尤易誘發抹平[1]。作者還發現,被測智能體很少打開所引網頁:一個系統僅打開了所引頁面的 19%(主要靠中位長度 585 字符的搜尋摘要寫作),另一個僅打開 2%[1];作者據此認為,抹平部分取決於智能體選擇讀取哪些資訊[1]。在一個基準 61 個問題上對兩個系統的干預表明,單加校準指令或單給完整全文都不足以單獨解決問題;唯有同時提供完整文檔與校準指令,實質性抹平才分別從 29% 降至 12%、從 61% 降至 25%,嚴重抹平幾乎消失(0.5% 與 2.2%),且報告未變短,論斷保留主旨並補上了限制條件[1]。該結論受限於模型評判器評分(經 73 條校驗)與研究型基準問題;同一系統內文檔數與論斷長度同抹平幾乎無關,説明仍有其他因素[1]。
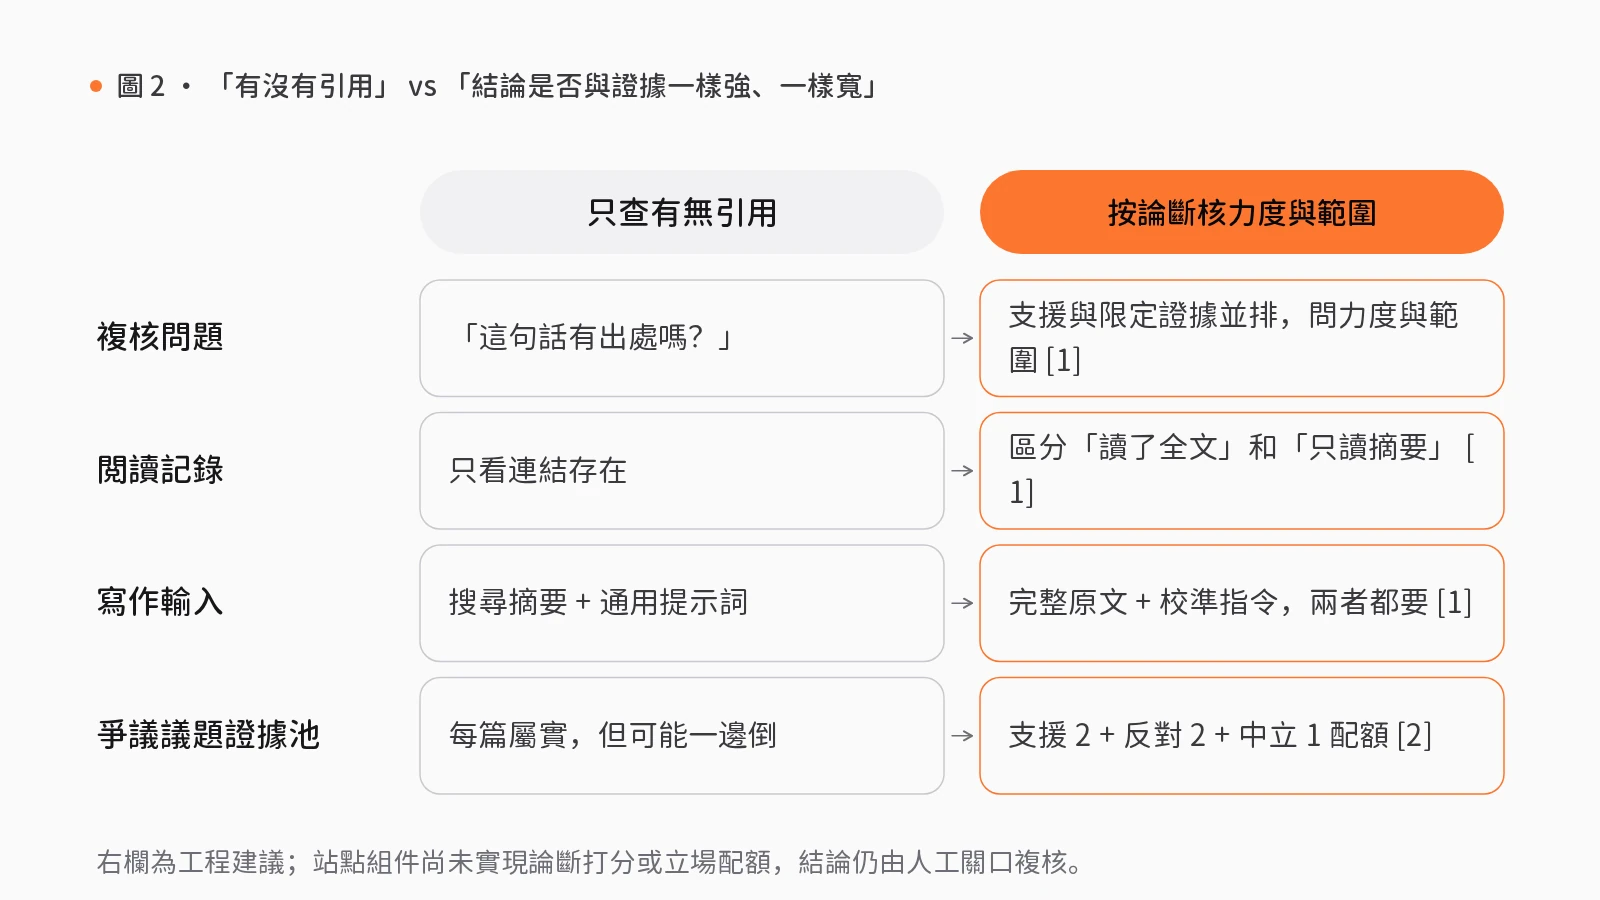
工程落地與 rlab.works 能力映射:論斷複核、閲讀留痕與配額約束
基於此,我們的工程判斷是:(1)在論斷層面並排展示支援與限定證據,核查結論力度與範圍是否匹配,而非只看有無引用;(2)記錄每處引用是否真正讀取全文,對僅靠摘要的論斷打標;(3)對爭議問題在寫作前固定支援、反對與中立證據配比;(4)同時向寫作端提供完整原文與校準指令;(5)重點盯防比較型與綜述型問題;(6)在人工關口展示反證與範圍邊界,允許審閲人下調措辭。
在 rlab.works 的智能感知與智能中樞模組中,可映射三項技能包與三項組件:
- 查資料與報告起草:智能感知的研究報告撰寫(S24)執行「拆解問題與範圍 → 收集材料 → 撰寫引用草稿 → 核對論據(人工關口) → 排版並匯出」,可配合有界的跨供應商研究工具循環(有迭代上限的檢索工具循環,返回引用與步驟證據)與有依據的文檔摘要(生成帶引用與源元數據的摘要,並標註兜底結果)。該包在法律行業可遷移:需替換論文來源與新聞主題模型,審查法律效力與判例適用性,不自動化出具法律結論。我們的工程判斷是在「核對論據(人工關口)」並排展示支援與限定證據,並標註引用頁是否已讀全文。
- 跨週期補查與複核:智能中樞的研究續查與歸檔(S08)執行「調取已有研究 → 制定補查計劃 → 批准後執行(人工關口) → 確認新發現(人工關口)」。該包在金融行業可遷移:研究執行仍需對接通用搜索與資訊增補隊列,因此整包未標為源數據直接支援的金融方案。我們的工程判斷是在「確認新發現(人工關口)」核查新證據是否收窄既有結論範圍,防止多輪彙總把局部結果抹平。
- 日常資訊彙集與簡報:智能感知的每日資訊簡報(S20)執行「採集並去重 → 提取事實 → 關聯相關事件 → 核實並篩選(人工關口) → 生成並發送」,可配合事件、實體與敍事圖譜構建(將文章關聯為事件與敍事,提取參與方及其立場)。該包在傳媒行業有源數據驗證:需配置欄目與訂閲範圍,編輯責任留在複核環節。我們的工程判斷是針對爭議議題在進入「核實並篩選(人工關口)」前核查立場配比。
需如實説明邊界:上述技能包均為基於合成數據演示的擬議未集成方案;三項組件雖經靜態源碼檢查標為可用,但目前均未對論斷力度與範圍打分、未強制立場配額,也不檢查被引用頁面是否真正打開——這些是我們從論文提煉的工程要求。本文不構成法律、投資或編輯建議。
研究智能體上線前的三項檢驗清單
- 核查全文打開記錄與雙條件輸入:確認日誌區分「僅讀搜尋摘要」與「已讀全文」,並為寫作環節同時配置完整原文與校準指令。
- 核查爭議議題的證據池配比:對存在合理分歧的問題,在檢索與生成間設定支援、反對與中立文檔配額,防止單邊材料主導結論。
- 核查人工關口的反證與降級機制:在「核對論據(人工關口)」「確認新發現(人工關口)」與「核實並篩選(人工關口)」同屏展示限定證據,支援審閲人下調措辭強度與範圍。
覺得有用?分享給需要的人。
參考文獻
- [1]
Roy, T. S., Wadhwa, M., & Durrett, G. (2026). Quantifying claim smoothing by LLM research agents (arXiv:2610.35793). arxiv.org ↗
- [2]
Yang, P., Dong, S., Wu, L., Cheng, X., & Li, B. (2026). Factual yet one-sided: Stance poisoning and evidence balancing in retrieval-augmented generation (arXiv:2610.34294). arxiv.org ↗
- [3]
Peters, U., & Chin-Yee, B. (2025). Generalization bias in large language model summarization of scientific research. *Royal Society Open Science*, 12(4), 241776. doi.org/10.1098/rsos.241776
相關能力
技能包
S24 · 智能感知
研究報告撰寫
撰寫研究報告時,大量時間用於查找資料、核對引用,仍難以説清每句話的出處。
先拆解研究問題,收集材料並標註出處,撰寫帶引用的草稿,論據經人工核對後排版匯出。
- 拆解問題與範圍
- 收集材料
- 撰寫引用草稿
- 核對論據人工複核
- 排版並匯出
5 步1 處人工複核8 個組件
S08 · 智能中樞
研究續查與歸檔
研究中途換人或間隔數週再接手,已查內容與結論依據難以找回。
研究範圍與證據全部存檔;補查前先報步驟與預算,經批准後執行,新發現經確認後歸檔。
- 調取已有研究
- 制定補查計劃
- 批准後執行人工複核
- 確認新發現人工複核
4 步2 處人工複核6 個組件
S20 · 智能感知
每日資訊簡報
每天需查閲數十個資訊源,重複多、有效少,轉述時還常遺漏出處。
自動採集並去重,提取事實與相關事件,經人工核實篩選後,生成可訂閲的每日簡報。
- 採集並去重
- 提取事實
- 關聯相關事件
- 核實並篩選人工複核
- 生成並發送
5 步1 處人工複核9 個組件