寫得更快,審得更薄:編碼提效指標達標之後,評審成了瓶頸
當管理層以人均合入代碼變更數設定編碼提效目標時,指標可以達成,但收益依賴個人數月累積使用,而代價會下沉到代碼評審。縱向實證顯示,代碼變更量增至三倍有餘而審閲人池僅增五成,實質性人工評審佔比近乎減半;工程上須將評審容量、覆蓋率與深度同吞吐指標並列管理。

產出計數翻倍之後,壓力去了哪裏
設想一家研發組織下達硬指標:一年內用人工智能工具將每位工程師每月合入的合併請求(即被接納進代碼庫的代碼變更)數量翻倍。一段時間後,看板上的合入曲線終於達標;可如果審閲人數沒有同步增加,待審的變更就只能靠無評論的「靜默批准」或自動放行來消化。
本文的核心論點是:當管理層圍繞單一產出計數設定提效目標時,數字可以達標,但它並非靠號令立竿見影,而是靠每人持續數月的累積使用,且代價集中落在下游人工評審上[1]。當編寫增速遠超審閲擴容,達標的吞吐計數便掩蓋了人工把關的稀釋[1, 3]。
從吞吐爬坡到評審稀釋:縱向實證、感知偏差與自動化濫用
一項追蹤企業編碼提效指令的縱向案例研究記錄了這一過程。He、Agarwal、Denisov-Blanch、Azaletskiy、Koyejo 與 Vasilescu(2026)分析了某家中型、積極採用人工智能的軟件企業在 2024 年 1 月至 2026 年 4 月間的內部遙測與變更歷史,覆蓋 802 名開發人員與 196,212 個合併請求[1]。2025 年 6 月,其技術負責人公開要求在十二個月內藉助人工智能將人均每月合入變更數翻倍,且工具預算不封頂[1]。研究採用非隨機的交錯雙重差分法,將每人啓用工具後的產出與自身此前對比,並以當月使用狀態未變的同事為參照[1]。
吞吐端,宣佈目標當月產出幾乎未動;每人啓用工具時產出約升 12%,隨後隨累積使用增長:嚴格日曆月控制下,觀測使用水平對應約 1.5 倍產出,個人用滿約九個月才達 2 倍;全公司人均 2 倍直到宣佈後第十個月(2026 年 4 月)才實現[1]。增量並非源於加班或拆碎提交:額外工作天數最多解釋總增幅的五分之一,變更規模反而變大(中位數 35 行升至 61 行),功能與缺陷修復增速快於日常維護[1]。各資歷增幅相近,但集中在 2022 年以來新建的代碼庫(+44%),老代碼庫增幅很小且不顯著(+12%)[1]。
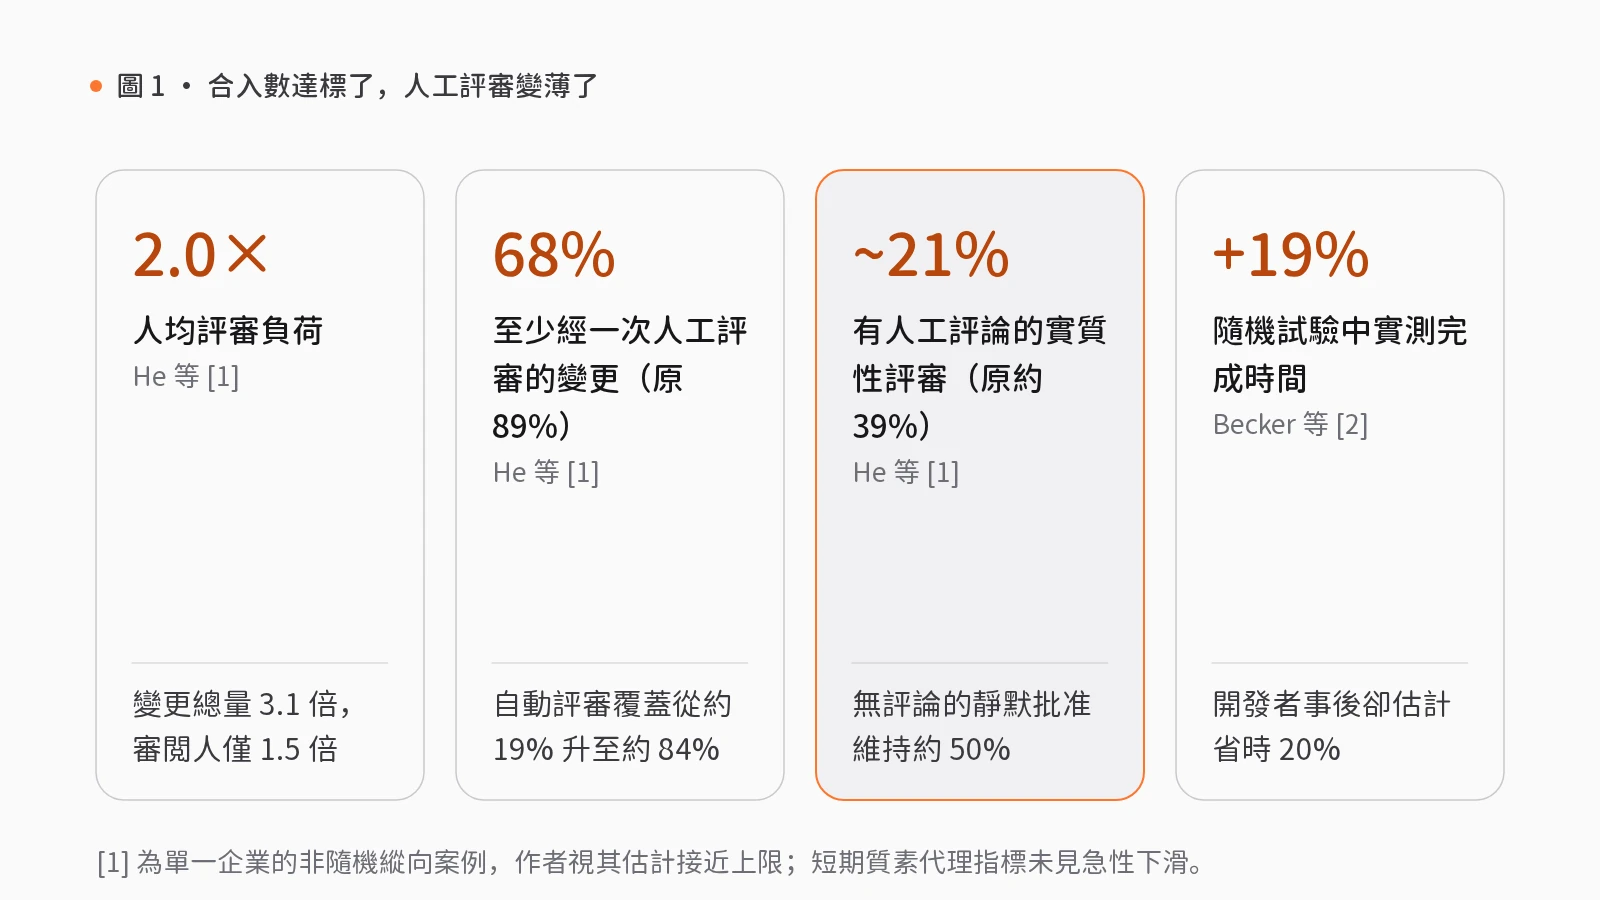
瓶頸集中在評審端。隨着人工智能編寫的變更佔到約 90%,全公司變更總量較 2025 年初基線增長 3.1 倍,而審閲人池僅擴大 1.5 倍,人均評審負荷約翻倍(2.0 倍)[1]。至少經一次人工評審的變更佔比從 89% 降至 68%,接受自動人工智能評審的佔比從約 19% 升至約 84%,在指令後不久反超人工——自動評審替代了部分人工評審而非僅作補充[1]。附帶人工評論的實質性人工評審佔比從約 39% 降至約 21%,無評論的靜默批准維持在約 50%;中位審閲人每月有評論的評審持平(約 3 次),靜默批准卻約翻倍[1]。控制規模後,同一作者同月內由人工智能編寫的變更從首次人工評審到合入耗時延長約 20%,總週期延長 22%(相關關係)[1]。觀察期後段,公司開始將變更路由至自動評審與自動批准——組織靠繞開人工評審而非加快人工審閲來維持節奏[1]。
短期質素代理指標未見急性崩塌:合入率持平、回滾佔比未升、作者在合入後也沒有更多地提交缺陷修復;但這些短期指標會漏掉缺陷、事故與可維護性,合入計數也未記錄「誰在審代碼」的轉移[1]。作者建議把這類指令視為轉型的起點而非一次工具部署,以季度為週期,先提升使用深度再要求達標,並按古德哈特定律的警示為目標指標配上其他信號,並像規劃編寫容量一樣規劃評審容量[1]。其侷限在於:樣本為單一預算不封頂且新代碼庫眾多的激進企業,估計值更接近上限而非行業均值;採納非隨機,效應量有不確定性;變更計數僅反映活動量,質素代理僅限短期[1]。
Parasuraman 與 Riley(1997)解釋了人類工效學風險:自動化誤用即過度依賴,易在負荷與可靠性影響下導致監控失效或決策偏差;棄用常源於誤報;而濫用是不顧人類作業後果推進自動化,使操作員角色淪為自動化的副產品並加劇誤用與棄用[3]。當評審負荷翻倍、自動評審接管覆蓋面時,人類的靜默批准便面臨淪為副產品的風險[1, 3]。
工程落地與 rlab.works 能力映射:評審容量、准入分類與注意力隊列
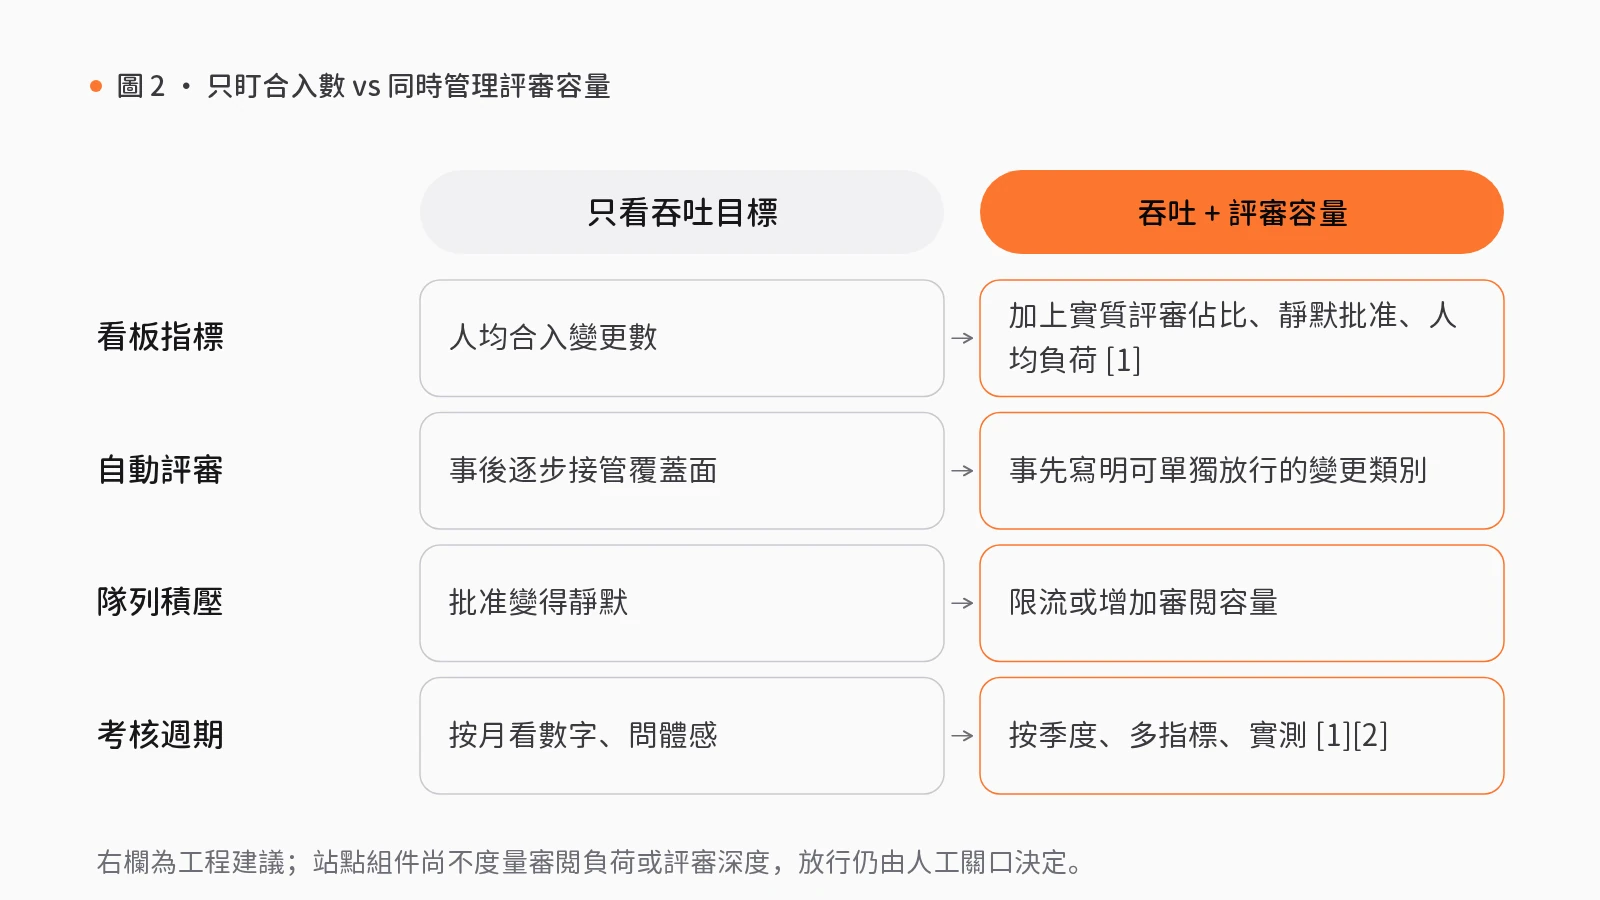
基於此,我們的工程判斷是:(1)在吞吐目標旁並列報告實質性人工評審佔比、靜默批准佔比、人均負荷與人工評審耗時;(2)上線前書面規定哪些變更可由自動評審單獨放行、哪些必須有人類評論;(3)把注意力隊列視為容量而非形式——負荷增速快於審閲人時應限流或擴容,而非任由批准變靜默;(4)記錄批准人與所據證據,事後區分「已批」與「已讀」;(5)按季度與多指標考核,不把感知問卷當證據[2]。
- 交付與複核關口:複雜任務拆解與執行(S01)執行「拆解任務清單 → 確認執行範圍(人工關口) → 逐項執行 → 驗收交付(人工關口)」,配合協作交付、審批與證據門檻(提供會話室、暫存草稿、注意力隊列、決策、產物版本、審批及有證據支撐的完成與交接)與可審計工作流、人工確認與決策復盤(版本化工作流與步驟、權限、暫停等待人工決定並記錄複核)。該包在製造業可遷移:僅編排軟件任務與人工記錄,物理檢修由人執行,需配置作業許可與檢查點。我們的工程判斷是在「驗收交付(人工關口)」按變更類別強制要求人工評論。
- 本地執行治理:經審批的電腦操作(S03)執行「準備帳戶與登入 → 審批操作清單(人工關口) → 執行並截圖 → 檢查改動(人工關口)」,配合本地編碼智能體執行治理(歸一化編碼智能體鈎子事件,在本地工具執行前判定允許、拒絕或需審批並記錄結果)。該包在法律行業可遷移:須顯式限制讀寫目錄,外部提交不在預設權限內。我們的工程判斷是在「檢查改動(人工關口)」留存結構化證據以控制下游審閲負荷。
- 發佈准入核驗:版本發佈與回退(S05)執行「整理發佈清單 → 演練備份恢復 → 批准上線(人工關口) → 分批上線 → 驗收或回退(人工關口)」。該包在能源行業可遷移:僅支援軟件交付,不控制場站設備,需適配離線環境、可信簽名與現場變更流程。我們的工程判斷是在「批准上線(人工關口)」核驗變更是否經過實質性人工審閲。
需誠實説明:所有技能包均為合成數據演示的擬議未集成方案;前兩項組件靜態檢查為可用,「可審計工作流、人工確認與決策復盤」為原型;上述技能包與組件目前均不度量審閲人負荷、評審深度(有評論或靜默批准)或自動批准佔比——這些是我們從論文提煉的要求。
設定研發提效目標前的三項行動清單
覺得有用?分享給需要的人。
參考文獻
- [1]
He, H., Agarwal, S., Denisov-Blanch, Y., Azaletskiy, P., Koyejo, S., & Vasilescu, B. (2026). AI writes faster than humans can review: A longitudinal study of an enterprise 2x mandate (arXiv:2607.01904). arxiv.org ↗
- [2]
Becker, J., Rush, N., Barnes, E., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity (arXiv:2507.09089). arxiv.org ↗
- [3]
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. *Human Factors*, 39(2), 230–253. doi.org/10.1518/001872097778543886
相關能力
技能包

S01 · 智能中樞
複雜任務拆解與執行
交由 AI 處理的複雜任務常中途停止或偏離目標,進度也無從查看。
先將目標拆解為有序的任務清單,經人工確認範圍後執行,交付前再次驗收。
- 拆解任務清單
- 確認執行範圍人工複核
- 逐項執行
- 驗收交付人工複核
4 步2 處人工複核7 個組件

S03 · 智能中樞
經審批的電腦操作
後台錄入、填表、修改文件等重複操作希望交由 AI 執行,又擔心誤操作。
AI 先列出操作位置與修改內容,經批准後執行;每一步均保留截圖與改動記錄。
- 準備帳戶與登入
- 審批操作清單人工複核
- 執行並截圖
- 檢查改動人工複核
4 步2 處人工複核8 個組件
S05 · 智能中樞
版本發佈與回退
新版本上線後出現問題,才發現未做備份、無法回退。
發佈前先演練備份恢復,經批准後分批上線;驗收未通過即回退至上一版本。
- 整理發佈清單
- 演練備份恢復
- 批准上線人工複核
- 分批上線
- 驗收或回退人工複核
5 步2 處人工複核11 個組件