跨越「鋸齒狀技術前沿」:任務顆粒度拆解如何決定企業 AI 的成敗
現場實驗顯示,大模型在看似相近的任務上表現可能截然相反;落地應以任務步驟為單位劃定模型的使用範圍,前沿外的步驟交給規則與人工複核。
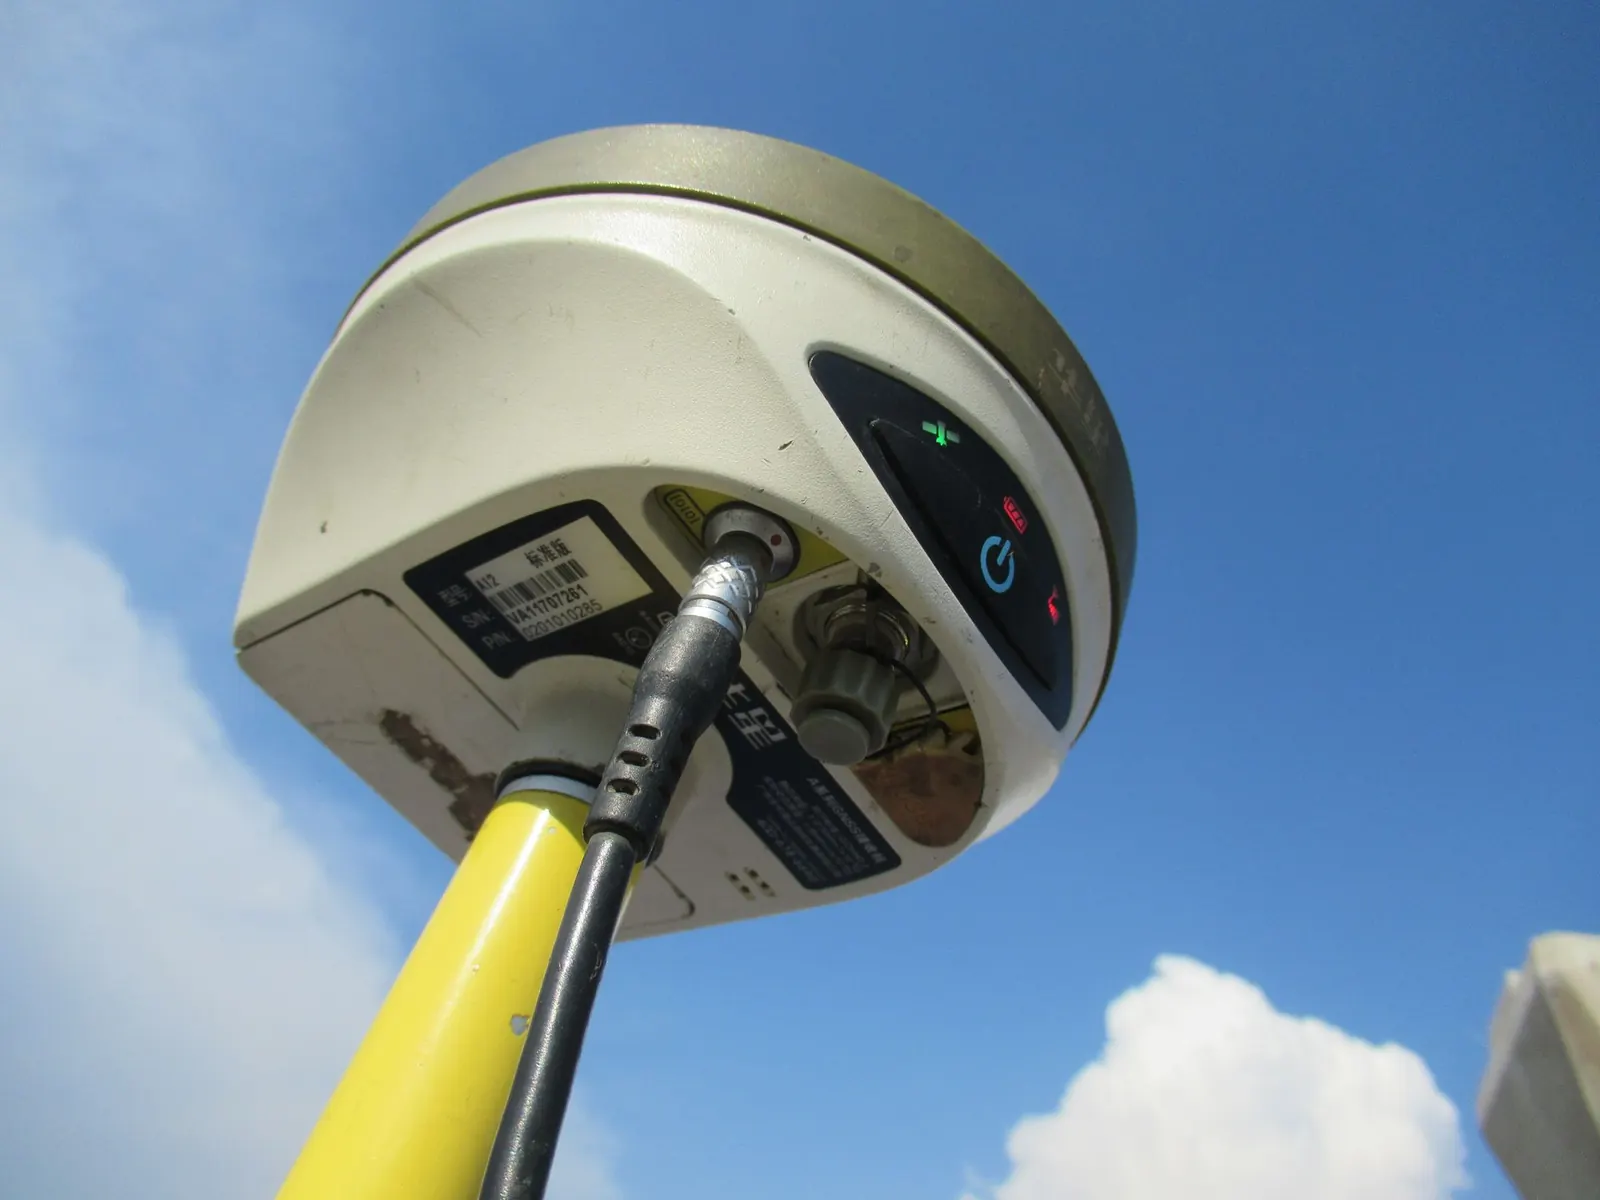

同一個業務流程裏,為何大模型既能提效又會誘發失誤
設想一個諮詢或投研團隊正在準備立項報告:分析人員讓大模型根據公開紀要整理競品論據、起草初稿,很快便得到了結構清晰的文本;於是團隊順勢將同一模型用於下一步——綜合存在細微矛盾的訪談記錄與表格數據,直接給出最終業務判斷。結果,表面通順的結論掩蓋了關鍵事實的錯配,直到評審會上才被發現。
這種反差源於把「崗位」或「整條流程」當作引入人工智能的單位。現場實驗顯示,大模型在看似相近的任務上表現可能截然相反;落地應以任務步驟為單位劃定模型的使用範圍,前沿內的步驟交給模型輔助,前沿外的步驟交給規則與人工複核。
從規則替代到「鋸齒狀技術前沿」:任務層面的經濟學與實驗證據
理解技術對工作的影響,首先要把分析顆粒度從「職業」下沉到「任務」。Autor、Levy 與 Murnane(2003)研究計算機化如何改變工作技能需求時指出,計算機資本一方面替代可通過遵循顯式規則完成的常規認知與體力任務,另一方面互補非常規問題解決與複雜溝通任務[2]。作者利用 1960 年至 1998 年的任務投入代表性數據發現,在行業、職業與教育羣體內部,計算機化伴隨着常規體力與常規認知任務勞動投入的減少,以及非常規認知任務勞動投入的增加[2]。將該模型轉化為教育需求後,可解釋 1970 年至 1998 年間偏向大學學歷勞動力的相對需求轉移估算值的 60%,而名義上相同職業內部的任務變化佔到了這一影響的近一半[2]。
大語言模型改變了「只有顯式規則任務才受技術觸及」的傳統邊界,但影響仍集中在任務層面。Eloundou、Manning、Mishkin 與 Rock(2024)通過考察技術與崗位任務的相關性(結合人工與大語言模型評估),估算在僅配備簡單界面與通用訓練時,約 1.8% 的工作崗位可能有超過一半的任務受大語言模型影響[3];而計入當前及未來可能補充大語言模型能力的軟件開發進展後,這一比例躍升至略高於 46% 的工作崗位[3]。需注意,這些數字是任務暴露度估算,而非失業或裁員預測;從單獨調用模型到結合互補軟件的躍升,也説明工作流軟件設計決定了模型潛力能否轉化為實際產出。
然而,即便在同一知識工作流內部,模型的能力邊界也絕非平整。Dell’Acqua 等人(2023)與一家全球管理諮詢公司合作開展預先註冊的現場實驗,提出「鋸齒狀技術前沿」(jagged technology frontier)概念:在同一知識工作流內、難度看似相近的任務上,人工智能輔助既可能提升表現,也可能惡化結果[1]。實驗以該諮詢公司的 758 名知識工作者為樣本,在類似任務上建立基線後,將受試者隨機分入無人工智能訪問、可使用人工智能、或可使用人工智能並附提示詞工程概覽這幾種條件[1]。在能力前沿內的 18 項真實管理諮詢任務(涵蓋創意到分析)中,使用人工智能者表現優於未使用者,多完成 12.2% 的任務,平均完成速度提升 25.1%,且方案質素顯著提高[1]。但在一項選定處於能力前沿之外的複雜管理任務上,使用人工智能者產生正確方案的可能性比未使用者低 19%[1]。若不加拆解地讓模型包攬全流程,前沿外的隱蔽錯誤就會抵消前沿內的效率增益。
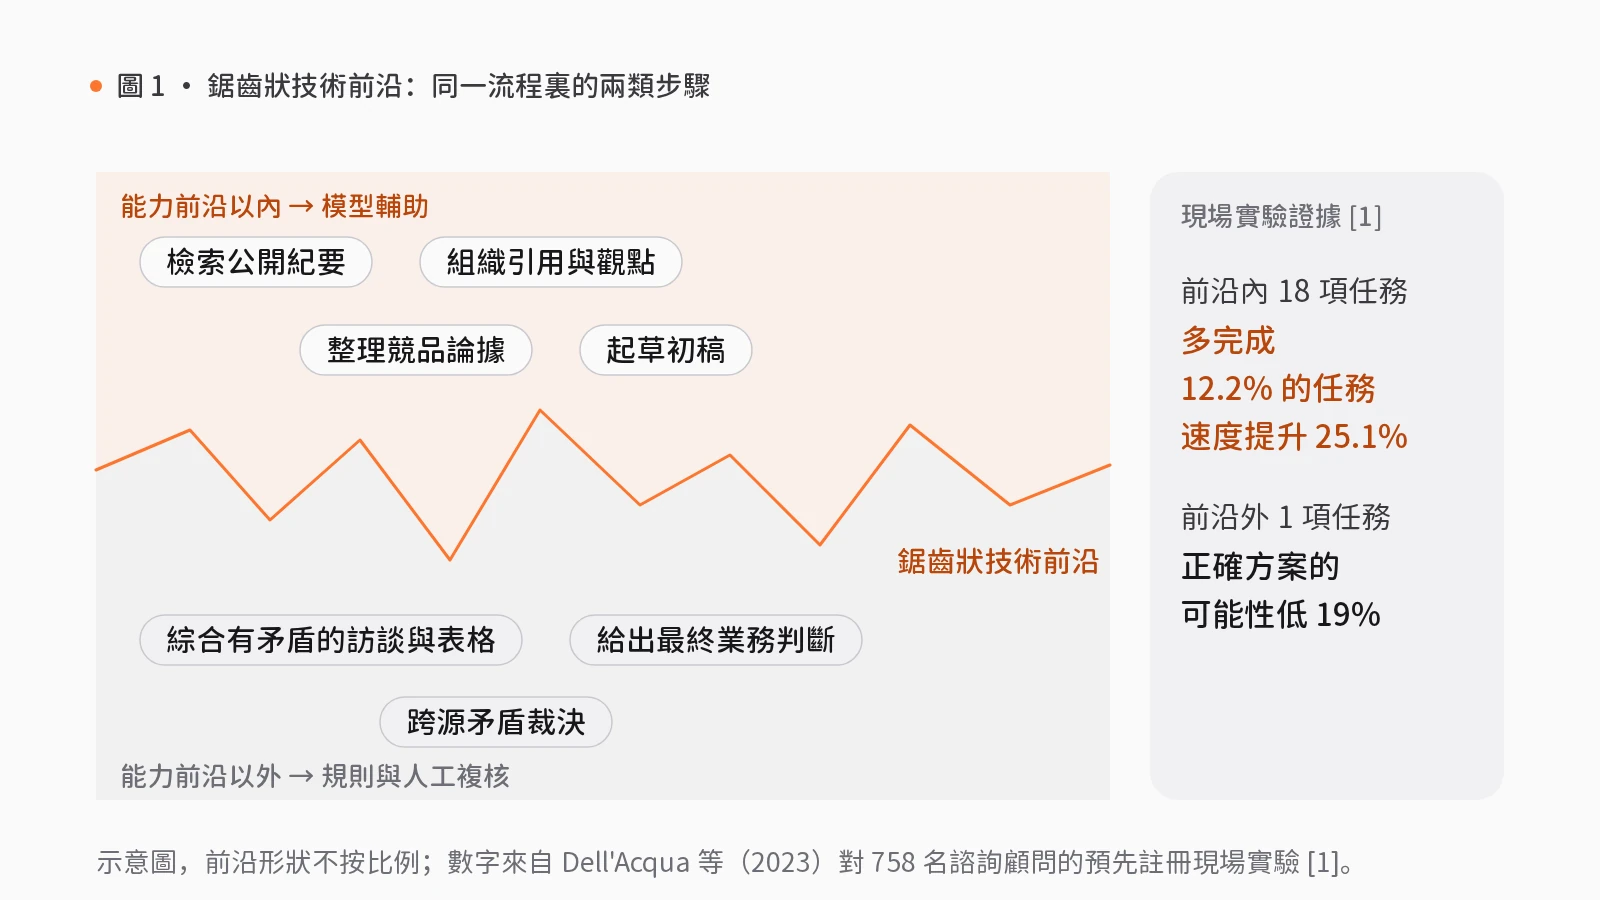
把任務拆解固化為工程邊界:輸入契約、分批核驗與人工關口
要跨越鋸齒狀技術前沿,系統必須把目標拆解為步驟,在前沿內外切換處設定人工關口。這一設計體現於 rlab.works 的智能中樞與智能感知模組中。
針對一般業務交付,「複雜任務拆解與執行(S01)」技能包以「目標、範圍和交付要求」為初始輸入:先由「目標規劃與版本化任務圖」組件(靜態源碼檢查為可運行代碼)執行輔助步驟「拆解任務清單」,生成帶依賴和執行方式的任務計劃,並支援計劃修訂的提議與比對;接着在人工複核步驟「確認執行範圍」由指定複核人或請求用戶審批,被拒產出退回修訂且不進入下一步;獲批後執行輔助步驟「逐項執行」,輸出任務結果和運行證據;最後經人工複核步驟「驗收交付」,產出已接受的交付包與複用記錄。其間,「可審計工作流、人工確認與決策復盤」組件負責持久化版本化工作流與步驟,在需人工決策時暫停並記錄結果。
針對長週期研究,「研究續查與歸檔(S08)」技能包以「研究問題、已有材料與可用時間」為輸入,按「調取已有研究(輔助,輸出可追溯的研究狀態與任務定義)→ 制定補查計劃(輔助,輸出需確認的研究步驟與預算)→ 批准後執行(人工複核,輸出經授權的新材料與計算結果)→ 確認新發現(人工複核,輸出已接受證據、未決問題與續查包)」推進,並可由「持久化研究工作區與記憶」組件(靜態源碼檢查為可運行代碼)保存研究會話、觀察與決策及會話包。「研究報告撰寫(S24)」技能包則以「研究問題、允許來源與報告提綱」為輸入,經過「拆解問題與範圍(輔助)→ 收集材料(輔助)→ 撰寫引用草稿(輔助,輸出帶引用的報告草稿)→ 核對論據(人工複核,輸出經核對的論據與報告內容)→ 排版並匯出(輔助)」,將檢索與草稿交給模型輔助,把論據核對鎖定在人工關口。
立項前的任務顆粒度檢驗清單
業務或技術負責人在資助試點前,可用以下標準檢驗方案是否正視了鋸齒狀技術前沿:
- 是否將工作拆解到帶依賴關係的步驟級? 拒絕籠統的「崗位替代」立項,明確區分檢索、提取、草稿組織等前沿內步驟與跨源矛盾裁決等前沿外步驟。
- 前沿交界處是否嵌入了具阻斷權的人工關口? 確認在範圍審批、預算確認與論據核對處設有人工複核,被拒產出必須退回修訂且不流入下游。
- 是否明確了行業遷移的接線與合規邊界? 核實是否限定了允許來源、保留了引文與運行證據,並確保系統不自動生成交易指令或法律結論。
覺得有用?分享給需要的人。
參考文獻
- [1]
Dell'Acqua, F., McFowland, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2023). Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of AI on Knowledge Worker Productivity and Quality (Harvard Business School Technology & Operations Mgt. Unit Working Paper No. 24-013). doi.org/10.2139/ssrn.4573321
- [2]
Autor, D. H., Levy, F., & Murnane, R. J. (2003). The Skill Content of Recent Technological Change: An Empirical Exploration. The Quarterly Journal of Economics, 118(4), 1279–1333. doi.org/10.1162/003355303322552801
- [3]
Eloundou, T., Manning, S., Mishkin, P., & Rock, D. (2024). GPTs are GPTs: Labor market impact potential of LLMs. Science, 384(6702), 1306–1308. doi.org/10.1126/science.adj0998
相關能力
技能包

S01 · 智能中樞
複雜任務拆解與執行
交由 AI 處理的複雜任務常中途停止或偏離目標,進度也無從查看。
先將目標拆解為有序的任務清單,經人工確認範圍後執行,交付前再次驗收。
- 拆解任務清單
- 確認執行範圍人工複核
- 逐項執行
- 驗收交付人工複核
4 步2 處人工複核7 個組件
S08 · 智能中樞
研究續查與歸檔
研究中途換人或間隔數週再接手,已查內容與結論依據難以找回。
研究範圍與證據全部存檔;補查前先報步驟與預算,經批准後執行,新發現經確認後歸檔。
- 調取已有研究
- 制定補查計劃
- 批准後執行人工複核
- 確認新發現人工複核
4 步2 處人工複核6 個組件
S24 · 智能感知
研究報告撰寫
撰寫研究報告時,大量時間用於查找資料、核對引用,仍難以説清每句話的出處。
先拆解研究問題,收集材料並標註出處,撰寫帶引用的草稿,論據經人工核對後排版匯出。
- 拆解問題與範圍
- 收集材料
- 撰寫引用草稿
- 核對論據人工複核
- 排版並匯出
5 步1 處人工複核8 個組件