先跑贏補貨公式:讓智能體經營門店之前,要過規則基線這一關
當語言模型智能體從替消費者比價轉向經營零售終端時,單點指標的改善並不自動轉化為更高的期末淨資產。在一項長週期自動售貨機經營基準測試中,五款智能體有四款輸給了經典的臨界比與定期補貨規則;工程上須在放權前以扣除推理成本後的淨值跑贏規則基線,並在提交前校驗單品可用庫存與人工審批閾值。

當智能體從代客下單走向看店訂貨
設想一家零售團隊準備把無人終端的日常經營交給語言模型智能體:選品、定價、下采購單,並付費派員上門上架。短期演示中,智能體寫出合理的選品理由並保持賬面盈利。但拉長到半年,這套耗費大量推理算力的系統,真的比寫進教科書幾十年的補貨公式賺得更多嗎?
本文的核心論點是:在長週期零售運營中,盈利不等於跑贏基線,單點指標改善也不等於期末淨資產增長[1]。在允許智能體下采購單或派員上架前,它必須在長週期內以扣除推理成本後的淨值跑贏簡單庫存規則基線,且每筆調撥須經單品可用庫存校驗與閾值審批。
長週期經營基準、在途錯覺與經典庫存權衡
Arrow、Harris 與 Marschak(1951)奠定了不確定需求下庫存決策的經典框架:最優庫存水平需在補貨提前期下權衡缺貨的期望損失與持有過多庫存的成本,據此決定重訂貨水準[3]。這一臨界比權衡正是確定性補貨規則的理論根基[1, 3]。
在一項長週期自動售貨機經營基準測試中,Shi、Li、Luan、Sun、Ma、Li、Jiang 與 Bai(2026)讓單個智能體通過含 18 項工具的網頁界面,在 180 個模擬日內經營共享同一倉庫的 20 台自動售貨機(分佈於 6 個工廠及工作場所、2 個校區、4 個社區、6 個商圈與 2 個辦公點共五類點位),目錄含 1,372 種商品,初始資金 40,000 元[1]。仿真器基於 220,128 件真實售貨機銷售記錄構建並校驗,需求參數對智能體隱藏;訂單下單即付款、提前期 3 天到倉,補貨或清理需按每台每天 35 元付費上門,批次保質期為到貨後 30 天或 90 天,售出過期品罰款 1,000 元,倉租每件每天 0.03 元、機位租每台每天 4 元,單機上限 200 件,核心指標為期末淨資產(現金加按成本計價的未過期庫存)[1]。確定性規則基線採用基於 Arrow 等人(1951)的臨界比與每週定期補貨至目標庫存策略,按滾動 30 天需求與波動率計算目標並計入提前期、庫存與在途訂單,在三個種子下取得 208.73 ± 2.26 千元淨資產(變異係數 1.1%)[1, 3]。
五款智能體在相同凍結環境、最高推理強度及統一提示詞、工具與每日交互預算下各運行三次,呈現四項事實[1]:
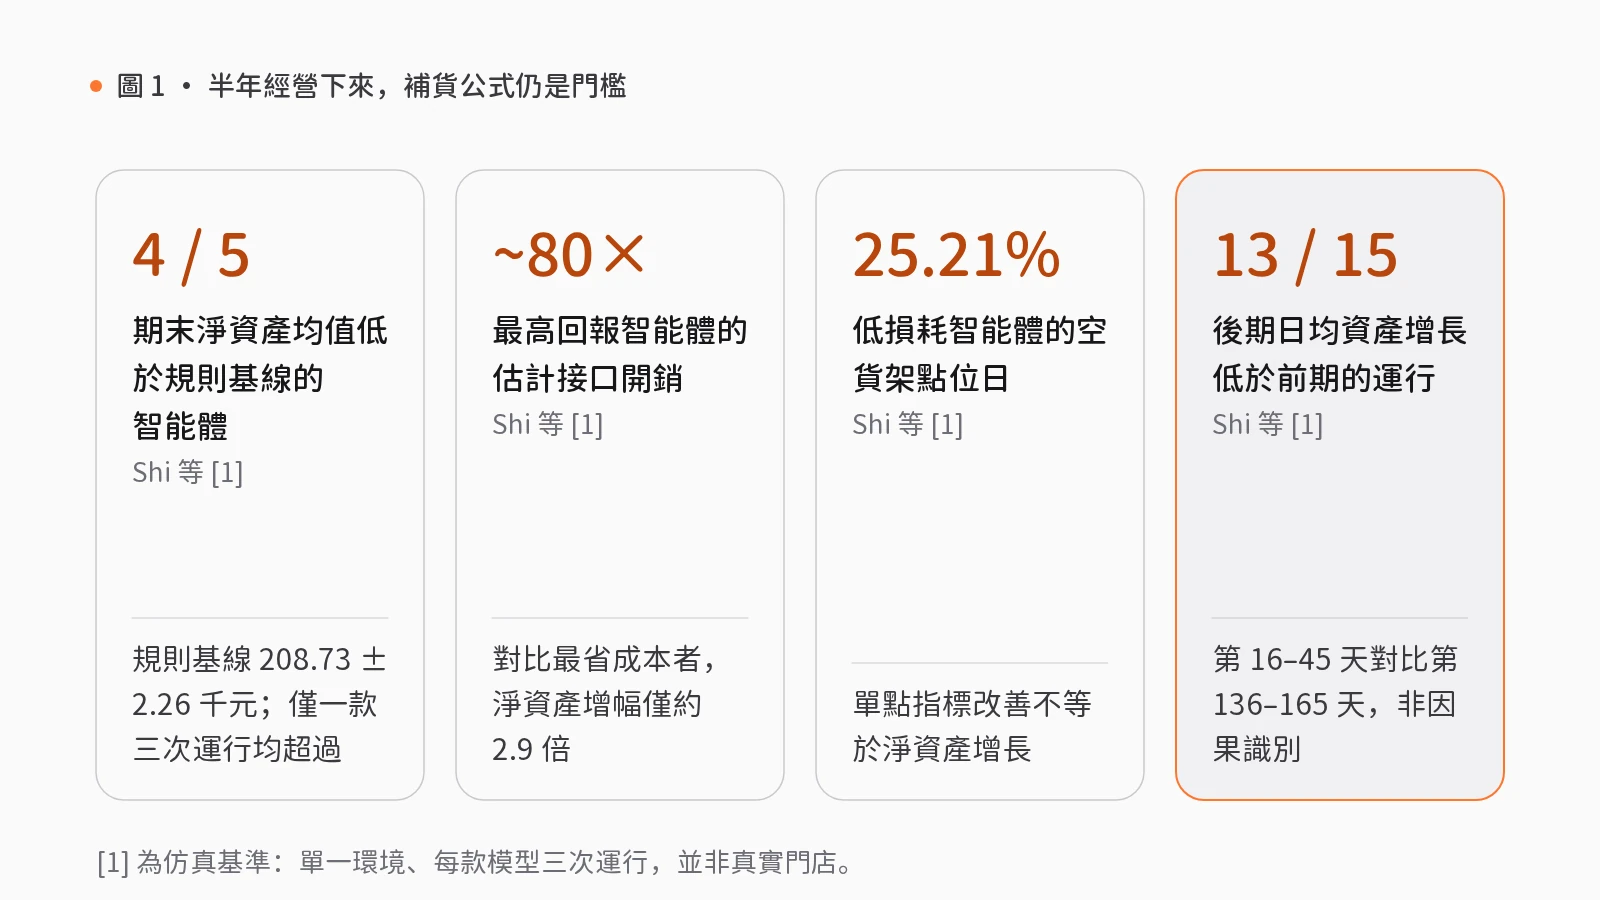
- 四款智能體均值低於規則基線:全部 15 次運行均高於初始資金,但五款中有四款的期末淨資產均值低於基線;僅一款在三次運行中均超基線(均值 309.35 千元),其餘 12 次無一超越,最低均值 91.52 千元,一款模型的跨運行變異係數達 45.6%(其餘約 11%)[1]。
- 高回報伴隨高昂推理開銷:按每美元估計接口成本計算的回報排序與純資產排序不同;最高回報智能體的估計接口開銷約為最具成本效益智能體的 80 倍,淨資產增幅僅為其約 2.9 倍[1]。
- 單點指標改善未帶來更多淨資產:無一智能體在盈利、選品、庫存與損耗、定價、資金效率五個維度全面領先,且五款的選品得分均低於基線[1]。一款智能體將低損耗與 25.21% 點位日的空貨架並存,另一款將空貨架壓至 1.67% 卻伴隨最高損耗率(1.85%)[1]。對比第 16 至 45 天與第 136 至 165 天,五款均值及 15 次運行中的 13 次日均資產增長下降;部分智能體的損耗或定價雖有改善,卻未轉化為更強的整體增長(作者指出該對比不能因果識別反饋是否改進決策)[1]。
- 説明性失效案例:作者列舉了典型個案(非發生率):某日補貨的 49 項調撥因單品倉庫庫存不足被全數拒絕,系訂單在途而智能體只看倉庫彙總件數;某在該時段無銷量記錄的商品倉內已有 2,158 件未過期庫存,仍被加購 80 件;某機器自上次巡檢僅賺 5.14 元毛利,卻花 35 元上門僅補 4 件;第 163 天被拒的 4 項不可行調撥在第 168 天重現,修正僅停留在當次交互而未留存為策略[1]。侷限在於:單一仿真環境、每模型運行三次,非真實門店[1]。
工程落地與 rlab.works 能力映射:准入基線、單品校驗與費用入賬
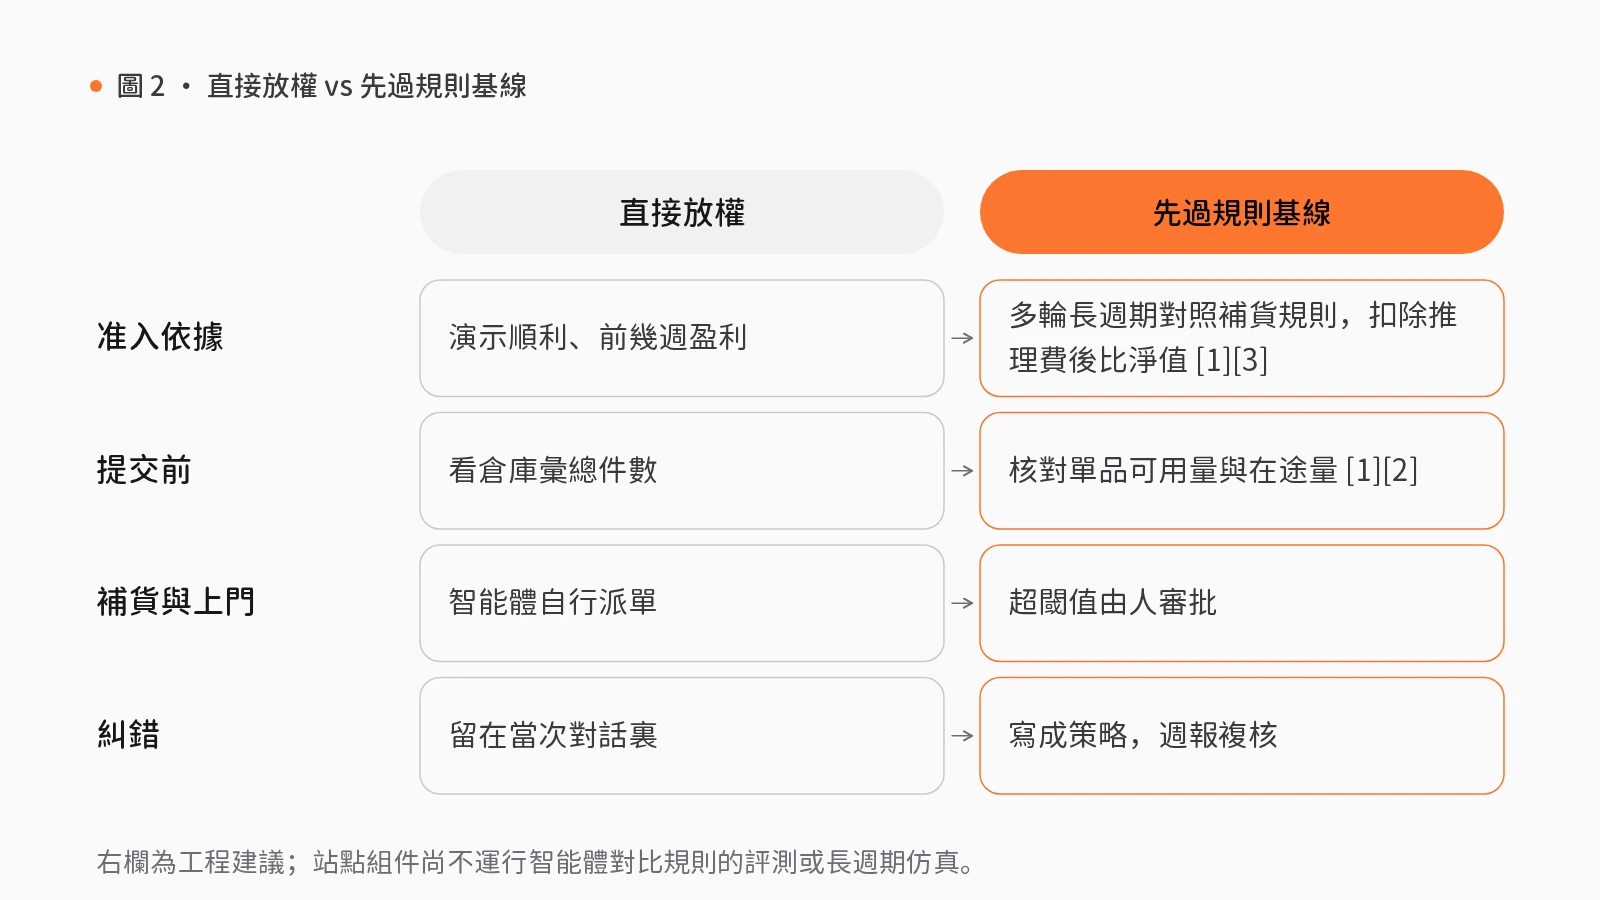
我們的工程判斷是:(1)下單前先在長週期仿真中與臨界比及定期補貨規則做多輪對照,按扣除推理成本後的淨值評估並報告跨運行波動;(2)每筆調撥與訂單提交前核對單品可用庫存與在途量,不看彙總件數;(3)超閾值補貨與上門派單保留人工審批;(4)以規則為兜底與預設策略,智能體建議偏離過大時回退;(5)把糾錯寫成策略並在週報複核,不靠上下文記憶;(6)將推理開銷記入運營成本同一賬本。
- 訂單履行與補貨審批:在智能商務模組,訂單履約與配送(S35)按「統一訂單資訊 → 查詢庫存並預留 → 批准補貨或拆單(人工關口) → 揀貨並派車 → 簽收並處理異常(人工關口)」運行,配合庫存台賬、批次管控、盤點與計價(預留、出入庫台賬、批次保質期凍結與檢驗、盤點差異及計價)與採購、補貨建議與供應商協同(帶審批的請購與採購單、到貨,及按銷量、庫存、未結訂單與提前期策略計算補貨)。該包在零售有源數據依據(物流為可遷移),需打通庫存、採購、出庫與配送標識,路線僅作參考,退款需單獨審批。我們的工程判斷是在「查詢庫存並預留」核驗單品可用與在途量,在「批准補貨或拆單」人工關口攔截超額採購與虧本派單。
- 推理費用核算:在模型網關模組,模型用量與費用核算(S13)按「預留預算 → 提交任務 → 逐筆記賬 → 人工對賬(人工關口)」運行,配合用量預留、預算、版本化定價與結算(預留與結算用量、執行預算、核對已計價與未計價台賬證據)。該包在金融與公共服務作內部工具成本管理屬可遷移應用,無零售標籤;此處可遷移用於核算智能體推理開銷,須指定單一計費歸屬方。
- 週度復盤與策略更新:在智能感知模組,經營週報(S26)按「彙總並統一數據 → 按時間與客羣比較 → 篩出異常 → 核對原因(人工關口) → 撰寫週報與跟進」執行。該包僅在出行酒旅有源數據依據且含酒店專用組件;遷移至零售屬可遷移應用,須替換酒店組件,且節假日重疊不是原因。我們的工程判斷是在「核對原因」人工關口將調撥報錯轉化為持久策略。
需如實説明:所有技能包均為合成數據演示的擬議未集成方案;三項組件均為可用狀態(前兩項含零售標籤),但均不運行智能體對比規則評測或長週期仿真——這是我們從論文提煉的要求。
放權智能體經營門店前的三項行動清單
覺得有用?分享給需要的人。
參考文獻
- [1]
Shi, Q., Li, Y., Luan, B., Sun, R., Ma, Y., Li, J., Jiang, D., & Bai, Z. (2026). AutoVend: Benchmarking LLM agents on long-horizon autonomous vending operations (arXiv:2610.36980). arxiv.org ↗
- [2]
Backlund, A., & Petersson, L. (2025). Vending-Bench: A benchmark for long-term coherence of autonomous agents (arXiv:2502.15840). arxiv.org ↗
- [3]
Arrow, K. J., Harris, T., & Marschak, J. (1951). Optimal inventory policy. *Econometrica*, 19(3), 250–272. doi.org/10.2307/1906813
相關能力
技能包
S35 · 智能商務
訂單履約與配送
訂單量大時,缺貨、拆單與配送異常全靠人工跟進,客戶詢問進度也難以答覆。
核對訂單與庫存並預留,補貨與拆單經人工批准後執行,再揀貨配送,簽收與異常逐單核對。
- 統一訂單資訊
- 查詢庫存並預留
- 批准補貨或拆單人工複核
- 揀貨並派車
- 簽收並處理異常人工複核
5 步2 處人工複核9 個組件
S13 · 模型網關
模型用量與費用核算
模型賬單月底才出具,超支後也難以説明費用花在哪些請求上。
調用前預留預算,運行後按每次請求記賬,對不上的差異逐條列出。
- 預留預算
- 提交任務
- 逐筆記賬
- 人工對賬人工複核
4 步1 處人工複核5 個組件
S26 · 智能感知
經營週報
編制週報的時間多用於統一表格口徑,真正的異常反而缺少分析。
先統一多張表格的口徑,篩出異常變化,原因經人工核對後寫入週報,並附跟進事項。
- 彙總並統一數據
- 按時間與客羣比較
- 篩出異常
- 核對原因人工複核
- 撰寫週報與跟進
5 步1 處人工複核11 個組件